リモート越しに測った数字は信じていいのか〜画面転送とベンチマークの干渉を実測する〜
リモート接続したまま測ったベンチマークの数字は信じていいのか。Macで模擬負荷、Windowsで本物のDeskIn接続を実測しました。汚れは1.5〜2.0%。ただし犯人は映像エンコーダではなく、画面取得が使うGPUの3Dエンジンでした。
プログラミングや3DCGで何か作りたいと思っているエンジニアがいます
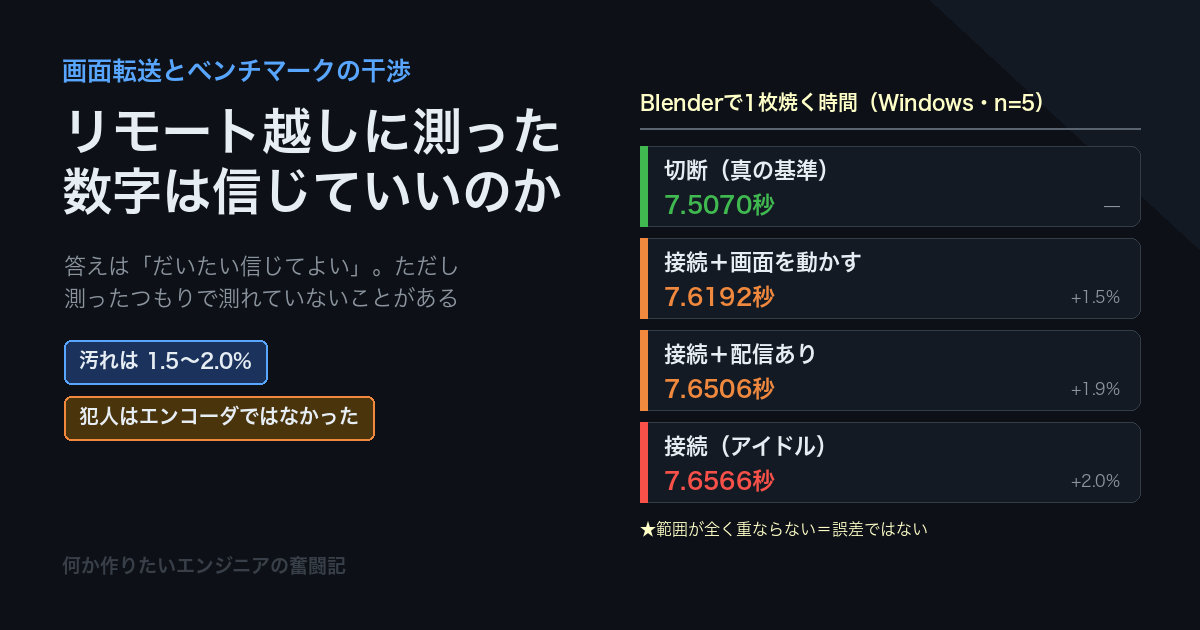
リモート接続したまま測ったベンチマークの数字は信じていいのか。Macで模擬負荷、Windowsで本物のDeskIn接続を実測しました。汚れは1.5〜2.0%。ただし犯人は映像エンコーダではなく、画面取得が使うGPUの3Dエンジンでした。

ローカルLLMで「モデルのどの部分をGPUに置き、どの部分をCPUに逃がすか」は自分で指定できます。llama.cppの -ngl / -ot / --n-cpu-moe を Apple M4・Radeon 780M・RTX 3060 の3構成で実測しました。統合メモリなら逃がしても損は小さいはず——という予想は外れ、M4では専門家をCPUへ回した瞬間に生成速度が37.77から2.53 tok/sへ、全部CPUに置くより10倍遅くなりました。真犯人はmmapで、--no-mmap を付けると6.6倍まで回復します。

どちらもCPUにGPUを内蔵しメインメモリを共有する「統合メモリ」構成。Apple M4(Mac)とRyzen 7 7840HSのRadeon 780M(ミニPC)で、同じQwen2.5-Coderの7B・14Bを同じ条件で走らせて比べました。生成速度は7BでM4が19.55 tok/s(MLXなら22.60)に対し780Mは13.37、14BはM4 10.69に対し780M 6.72。M4が約1.5倍速い一方、メモリ帯域の差は120GB/s対89.6GB/sの1.34倍しかありません。帯域だけでは説明できないこの差の正体を、iPhone由来のApple GPUとグラフィックボード由来のRDNA 3という両者の設計の出自から掘り下げます。

外付けRTX 3060でゲームを動かし、同じPCの内蔵GPU Radeon 780MでローカルLLMを同時に走らせたらどうなるかを実測しました。結論は「成立する。ただし代償は平均fpsではなくフレームの安定性に出る」。平均fpsは-15.7%で済むのに、1% Lowは-43.3%、0.1% Lowは-47.9%まで落ち込みます。GPU同士は競合しておらず、犯人はDDR5メモリコントローラでした。AI側も生成-8.7%に対しプロンプト処理-20.8%と削られ方が違う。アプリごとにGPUを割り当てる設定方法と、対戦ゲームでは避けるべき理由まで実測値つきで整理します。

1台のミニPC(Ryzen 7 7840HS)で、内蔵GPU Radeon 780M(統合メモリ)と外付けRTX 3060(OCuLink接続のeGPU)を切り替えて実測しました。llama.cpp Vulkanで7B・14B・MoE 30B-A3Bの3種類を測ると、ゲームは全指標きっちり3.47倍差なのに、AIはモデル次第で1.67〜10.8倍と振れ幅が段違い。さらに「BIOSでVRAM割当を増やさないと大きいモデルは載らない」という予想が外れ、512MB設定のまま14.2GBを確保できた理由も判明。-ngl 99を付けると起動すらしない罠、Smart App Controlが公式バイナリを弾く問題まで実測値つきで記録します。

CPUの命令セットが「オープン」であるRISC-Vを調べました。無償なのは使用許諾だけで実物の回路設計は有料が主流という誤解のほどき方、長年の「バラバラ問題」に決着をつけた2024年10月のRVA23批准、電子工作でおなじみのESP32-C3/C6が実はRISC-Vだったこと、Bosch・Infineonら6社のQuintaurisが2026年1月に出した車載向けRT-Europa、Ubuntu 26.04 LTS。6千円台のボードから0円のQEMUまで試す方法と、周辺機器ドライバやデバッグの弱点も正直に整理します。

ロボットや工場の機械など「PCではない場所」でAIを動かすチップを調べました。NVIDIA Jetson Thorと2026年7月発表の新モデルT3000/T2000、安全認証に強いAMD Versal AI Edge Gen 2、長期供給を掲げるQualcomm Dragonwing、1万9千円台のRaspberry Pi AI HAT+ 2、そして終了したGoogle Coral。TOPSやFPGA、ASIL Dといった用語を解説しながら用途別の選び方を整理します。

最近のPCには当たり前のようにNPUが載っています。ローカルLLMをNPUで動かせるのか調べたら、Ollama・llama.cpp・LM Studioといった主流ランタイムは、そもそもNPUを使っていませんでした。なぜLLMが苦手なのか(想定モデルサイズとメモリ帯域)を図解し、さらにMacのNeural Engineで実測。float16にするだけで約10倍、450MBまでは3倍速、806MBでコンパイル失敗という「NPUを最大限に使う条件」を数字で確かめ、今NPUを存分に活かせる場面も整理しました。

ローカルLLMをGPUで動かしてきた流れで、その土台を作っている半導体3社の『これまで』と『これから』を同じ切り口で並べました。創業から今の性格ができるまでを年表で整理し、データセンター(Vera Rubin/MI400・Helios)、AI PCのNPU(Panther Lake/Ryzen AI)、エッジ・組み込み(Jetson Thor/Versal)の3レイヤで比較。NVIDIAは土台まるごと、AMDは開かれた選択肢、Intelは作れること——各社の勝ち筋を地図にしました。
パソコンの主なパーツが何をしているのかを机の上の作業にたとえて整理しました。混同しやすいメモリとストレージの違い、コア数と周波数の効き方、HDDとSSD、冷却、デスクトップとノートの違いまで扱っています。