この記事について
Blenderには Python が組み込まれていて、画面を開かずにコマンド1行で動かすこともできます。以前 BlenderのPythonスクリプトで3Dモデルを自動生成する でスクリプトの書き方を扱いましたが、あのときは Blender の画面の中で「実行」ボタンを押していました。
今回はその先です。GUIを開かずに、同じ手順を100個ぶん回して書き出す。モデルの変換やサムネイルの量産、レンダリングの一括処理など、実務でいちばん出番の多い使い方です。p976・p977 のレンダリングの計測や、p973 の街の組み立ても、裏ではこの方法で回していました(p973 の描画時間だけは画面が要るので、画面ありで測っています)。
やってみて分かったのは、画面を開かない処理は、失敗しても何も言ってくれないということです。エラーのダイアログは出ませんし、画面が止まって見えることもありません。そこでこの記事では、「100個回したつもりで、実は何が起きていたか」を6つの実験で確かめました。
先に結論(Mac・Windowsとも同じ結果)
① スクリプトが例外で落ちても、スクリプトのファイルが存在しなくても、終了コードは0(成功)。100個中37個目で止まっても0でした
② 後片付けをきちんとするほど、書き出したファイルが上書きされて100個が1個になる。しかもエラーは1件も出ない
③ 「オブジェクトだけ消す」片付けはメモリがまったく減らない(2048pxのテクスチャで +2.5GB)
④ 1個ずつBlenderを起動し直すと、1回の起動で回すより EEVEEで19倍・Cyclesで6.3倍遅い
⑤ 画面ありで起動してスクリプトを渡すと、画面なしより失敗が多い(16操作中 11 → 6)
この記事には、Blenderを起動する時間などを測った実験が6つあります。レンダリングを伴う実験4だけは Windows(RTX 3060)で測り、それ以外は Mac と Windows の両方で同じスクリプトを走らせました。
用語集
Blenderそのものの言葉、スクリプトの言葉、実行と結果の言葉、の順に並べています。
| 言葉 | 何を指すのか |
|---|---|
| メッシュ/マテリアル/テクスチャ | 3Dモデルを作る材料。メッシュは形(点と面の集まり)、マテリアルは見た目の設定(色・つや)、テクスチャは表面に貼る画像。今回の元ファイルには、1個ごとに縞模様のテクスチャを1枚入れている |
| モディファイア | 形を後から加工する部品。今回は面の数を減らす Decimate(デシメート)を使い、面を半分にしている。「適用」すると加工が形に焼き込まれる |
| 編集モード | 点や面を1つずつ直接いじるための状態。ふだんの「オブジェクトモード」から切り替えて使う |
| ビューポート | Blenderの画面の中で、3Dの様子を映している窓の部分。マウスで回して眺める場所 |
| EEVEE/Cycles/Workbench | Blenderに入っている3つの描画方式(レンダーエンジン)。EEVEEはゲームと同じやり方で速く描く、Cyclesは光の跳ね返りを計算して写実的に描く(そのぶん重い)、Workbenchは色と形だけを確認する簡易表示。詳しくは p976 |
| OptiX/Metal | CyclesがGPUで計算するときの仕組み。OptiXはNVIDIA(今回のRTX 3060)用、MetalはApple(Mac)用 |
| シェーダとウォームアップ | シェーダはGPUが絵を描くための小さなプログラム。最初に使うときにGPU向けに準備(変換)するので、初回だけ時間がかかる。計測の前に1回わざと動かして、この準備を済ませておくのがウォームアップ |
バックグラウンド実行(-b) | Blenderを画面を出さずに起動すること。ウィンドウは開かず、スクリプトを実行して終わる。サーバーや夜間の一括処理はこれで回す |
| bpy | Blenderを Python から操作するための部品(Blender Python API)。import bpy で使う |
オペレーター(bpy.ops.*) | メニューやボタンの操作をそのまま呼ぶ命令。「立方体を追加」「glTFで書き出し」など。画面の状態(今どこを選んでいるか)に左右されるのが弱点 |
| コンテキスト | 「今どのウィンドウの、どの区画で、何が選ばれているか」という操作の前提。オペレーターはこれを見て動く。画面が無いと、この前提の一部が欠ける。中身は大きい順に window(ウィンドウ)→ screen(ウィンドウの中の画面の配置)→ area(3Dビューなど1つの区画)→ region(区画の中の、実際に絵が描かれる領域) |
| データブロック | Blenderの中身の単位。オブジェクト・メッシュ・マテリアル・画像はそれぞれ別のデータブロックで、オブジェクトを消しても、中のメッシュや画像は残る |
| 孤立データ(orphan) | どこからも使われなくなったデータブロック。bpy.data.orphans_purge() で掃除できる |
| 例外(try/except) | Pythonで処理が続けられなくなったときに起きる「エラーの知らせ」。何もしなければそこでスクリプトが止まる。try: で囲んだ部分で起きた例外は、except: の側で受け止めて、止めずに次へ進める |
| プロセスと並列 | プロセスは、起動して動いている1つのプログラム。Blenderを4つ同時に起動すれば4プロセスで、それぞれに仕事を分けて同時に進めるのが並列。起動のたびに準備の時間がかかる |
| 終了コード | プログラムが終わるときに返す数字。0が成功、それ以外が失敗というのが決まりごと。一括処理を見張る仕組みは、この数字だけを見て成否を判断する(夜間に自動で動かすタスクスケジューラ、変更のたびに自動で処理を回すCI、コマンドを並べたバッチファイルなど) |
パイプ(|) | 左のコマンドの出力を、右のコマンドに渡してつなぐ記号。… | grep done なら「done を含む行だけ表示」。つなぐと、最後に表示される終了コードは右側のコマンドのものになる |
| glTF/glb/FBX | 3Dモデルを受け渡すためのファイル形式。glTFは標準的な形式で、glbはそれを1ファイルにまとめたもの(ゲームエンジンやWebで広く読める)。FBXは Autodesk 社の形式で、3Dソフトやゲームエンジンの間でよく使われる |
| CSV | 表を、1行ずつカンマ区切りの文字で保存したファイル。Excelなどの表計算ソフトでそのまま開ける。今回は1個ごとの結果をこれで残している |
| LTS | Long Term Support(長期サポート版)。Blenderでは約2年間、不具合の修正版が出続ける版。5.2.2 の最後の数字が、その修正の回数にあたる |
【基本形・両OS】Blenderをコマンドから動かす
まずは形だけ押さえます。Blenderの実行ファイルに -b(画面なし)と --python(実行するスクリプト)を渡すだけです。
# Mac
/Applications/Blender.app/Contents/MacOS/Blender -b --factory-startup --python convert.py -- --src src --out out

# Windows(インストーラ版の場所。zip版なら展開した場所の blender.exe)
"C:\Program Files\Blender Foundation\Blender 5.2\blender.exe" -b --factory-startup --python convert.py -- --src src --out out
押さえておく点は3つです。
--factory-startup… 自分のPCの設定(起動画面のファイル・有効にしたアドオン)を読まずに、出荷時の状態で起動する。別のPCで同じ結果を出したいときに付ける--(ハイフン2つ) … ここから後ろは Blender ではなくスクリプトへの引数になる。付けないと Blender 自身が--srcを解釈しようとする- 引数は左から順に実行される … これが実験6の落とし穴につながる
スクリプトの側では、-- より後ろだけを取り出して読みます。
import sys, argparse

def args():
    a = sys.argv[sys.argv.index("--") + 1:] if "--" in sys.argv else []
    p = argparse.ArgumentParser()
    p.add_argument("--src", required=True)
    p.add_argument("--out", required=True)
return p.parse_args(a)今回の題材は、100個の glb ファイルを「読み込む → 面を半分に減らす → glbで書き出す(→ サムネイルを焼く)」という変換です。元のファイルは、中身の名前がどれも同じ(オブジェクト Model・マテリアル Material)になるように作りました。別々の人や別々のツールが書き出したファイルは、名前がぶつかっているのが普通だからです。この「普通」が実験3で効いてきます。
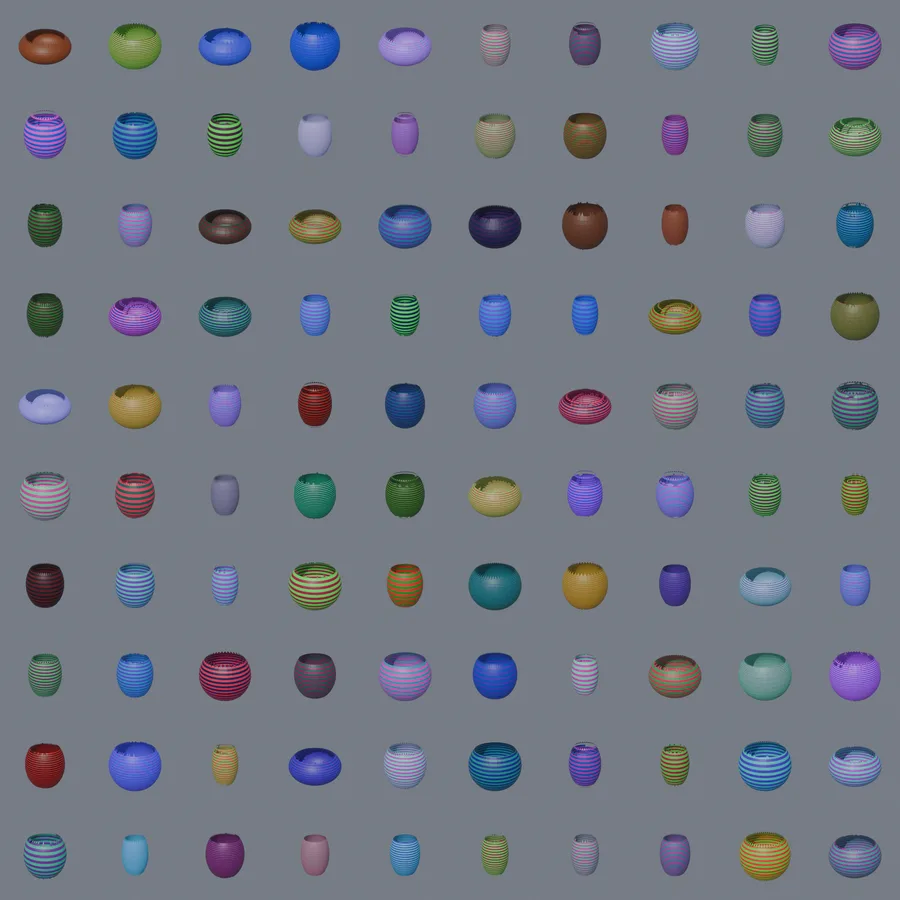
これが Windows で焼き上がった100枚です(EEVEE・256×256)。面を半分に減らしたので、どれも少し形が崩れています😅 このサムネイル100枚は、コマンド1行・15.3秒で出てきました。
【準備・両OS】スクリプト一式と、動かし方
この記事の実験は、すべて次の5つのスクリプトで回しています。全文は記事の最後の【付録】に載せました。まとめて p998_scripts.zip(5ファイル・約42KB)からも取れます。
make_sources.py(Blenderの中)… 材料づくり。変換の元になる glb を100個つくる(中身の名前はすべてModel)convert.py(Blenderの中)… 変換の本体。読み込む → 面を半分に減らす → 書き出す(→ サムネイル)。片付け方や名前の決め方をオプションで切り替えるprobe_ops.py(Blenderの中)… 実験5。16個の操作を1つずつ試して、動いたかどうかを残すerr.py(Blenderの中)… 実験2。わざと例外で落ちるだけrunner.py(Blenderの外・Python 3)… 上の4つを、条件を変えながら何十回もBlenderに渡して、結果を CSV にまとめる
5つとも同じフォルダに置きます。ここでは Mac は ~/p998、Windows は C:\p998 としました。Blender 本体は、公式サイトのダウンロードページから入れた通常版でかまいません(Windows は zip 版を展開しただけでも動きます)。この記事は両OSとも Blender 5.2.2 LTS(執筆時点の最新版)で確かめています。
Macで動かす(ターミナル)
「アプリケーション」→「ユーティリティ」→「ターミナル」を開き、1行ずつ打ちます。B= の行は、長いBlenderの場所に短い名前を付けているだけです。
cd ~/p998
B=/Applications/Blender.app/Contents/MacOS/Blender
$B --version
# → Blender 5.2.2 LTS

# ① 材料を100個つくる(out/src/ に src_000.glb 〜 src_099.glb)
$B -b --factory-startup --python make_sources.py -- --n 100 --tex 512 --out out/src

# ② 100個を変換する(片付け=purge・名前=元ファイル名。いちばん安全な組み合わせ)
$B -b --factory-startup --python-exit-code 1 --python convert.py -- --src out/src --cleanup purge --name-from source --out out/conv
echo $?
# → 0
ls out/conv/items/*.glb | wc -l
# → 100
②の実行中は、1個ごとの記録が out/conv/log.csv に1行ずつ増えていきます。ターミナルの最後にはこう出ます。
[p998] convert blender 5.2.2 LTS platform=darwin cleanup=purge name_from=source render=none files=100
[p998] done files=100 fails=0 out_glb=100 sec=1.54⚠echo $? は直前のコマンドの終了コードを表示します。$B ... | grep done のようにパイプでつなぐと、Blenderではなく grep の終了コードが出ます(この確認中に実際に踏みました😅)。終了コードを見たいときは、パイプを付けずに実行してください。
実験3の「100個が1個になる」と、実験2の「37個目で止まっても0」は、次のコマンドで再現できます。
# 名前をオブジェクト名から作ると、上書きされて Model.glb の1個だけになる
$B -b --factory-startup --python-exit-code 1 --python convert.py -- --src out/src --cleanup purge --name-from object --out out/conv_obj
ls out/conv_obj/items/
# → Model.glb

# 37番だけ壊したコピーを作り、素朴な書き方(--naive)で回す
cp -R out/src out/src_broken
printf 'this is not a glb file' > out/src_broken/src_037.glb
$B -b --factory-startup --python convert.py -- --src out/src_broken --cleanup purge --name-from source --out out/naive --naive
echo $?
# → 0(なのに)
ls out/naive/items/*.glb | wc -l
# → 37
全部の実験をまとめて回す(Mac・Windows共通)
記事の数字は、runner.py で実験0〜6をまとめて回して取りました。runner.py は Blender ではなく、ふつうの Python 3 で動かします。Mac はターミナルの python3、Windows は python.org から入れた Python 3 を使いました(Mac で python3 が見つからないと言われたら、python.org から入れてください)。
# Mac(ターミナル)
cd ~/p998
python3 runner.py --blender /Applications/Blender.app/Contents/MacOS/Blender

# Windows(PowerShell)
cd C:\p998
python runner.py --blender "C:\Program Files\Blender Foundation\Blender 5.2\blender.exe"
Windows の検証機では全部で17分18秒かかりました(半分以上は実験4の「1個ずつ起動し直す」200回)。オプションは3つあります。
--only e2,e3… 一部の実験だけ回す(e0〜e6)--quick… 回数と個数を減らした短縮版。実験4はWorkbenchで6個だけ焼く(Macで約50秒)--no-gui… Blenderの画面が一瞬開く実験(実験5の2つ)を飛ばす
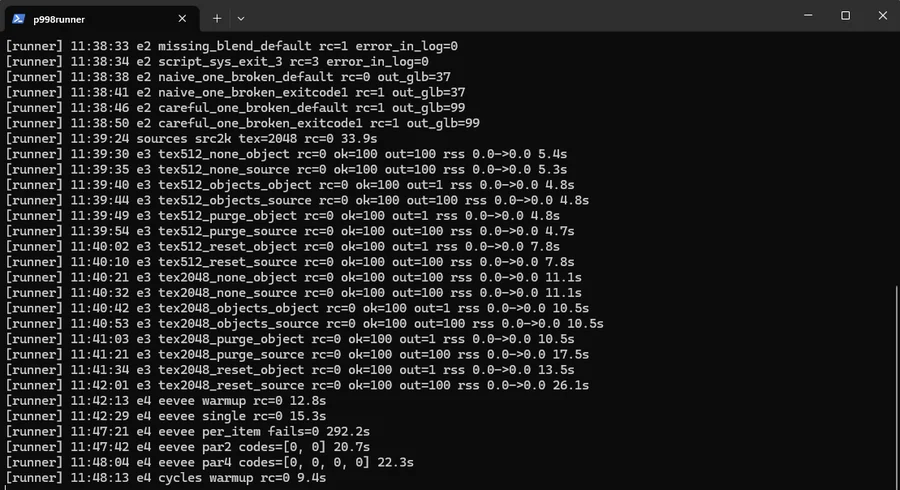
実行中は、こういう行が1実験ごとに流れます(後で出てくる実行画面の写真も、この表示です)。
[runner] 11:38:38 e2 naive_one_broken_default rc=0 out_glb=37
[runner] 11:39:40 e3 tex512_objects_object rc=0 ok=100 out=1 rss ...
[runner] 11:47:21 e4 eevee per_item fails=0 292.2s
結果は out/ の下に、実験ごとの CSV として残ります(e1_startup.csv〜e6_paths.csv)。Blenderに渡した実際のコマンドは、out/logs/ の各ファイルの1行目にそのまま書かれるので、1つだけ手で打ち直したいときはそこからコピーするのが確実です。
普段のBlenderの設定は汚さない
runner.py は、Blenderの設定置き場を スクリプトと同じフォルダの blender_home/ に切り替えてから起動します(環境変数 BLENDER_USER_RESOURCES)。フォルダごと消せば元どおりです。例外は実験1の「普段の設定を読む」条件だけで、これは読むだけで書き込みません。
【実験1・両OS】起動にかかる時間 ── Windowsは Mac の約3.5倍
再現:runner.py --only e1(out/e1_startup.csv)
最初に、何もしないスクリプトを渡して起動して終わるまでの時間を測りました。1回目はウォームアップとして捨て、残り5回の平均です。
| 条件 | Mac(M4) | Windows(Ryzen 7 7840HS) |
|---|---|---|
-b --factory-startup --python-expr pass | 0.46秒 | 1.59秒 |
普段の設定を読む(--factory-startup なし) | 0.49秒 | 1.61秒 |
| 立方体を1個追加して終わる | 0.46秒 | 1.60秒 |
Windows は Mac の約3.5倍でした。しかも1回目から最後まで1.56〜1.67秒でほぼ一定で、繰り返しても縮みません。キャッシュが効いて速くなる種類の遅さではない、ということです。設定を読むかどうか、オペレーターを1回呼ぶかどうかは誤差の範囲でした。
「1.6秒なら気にならない」と思うかもしれません。ところが100個を1個ずつ起動し直すと、それだけで 160秒です。この差が実験4でそのまま効いてきます。
【実験2・両OS】失敗しても「成功」が返ってくる
再現:runner.py --only e2(out/e2_exitcode.csv)
一括処理を見張る仕組みは、ふつう終了コードしか見ません。そこで、わざと失敗させて何が返るかを記録しました。
| 何をしたか | 終了コード(既定) | --python-exit-code 1 を付けると |
|---|---|---|
| スクリプトが例外で落ちる | 0 | 1 |
--python-expr "1/0"(ゼロ割り) | 0 | 1 |
| スクリプトのファイルが存在しない | 0 | 1 |
| 開く .blend が存在しない | 1 | — |
スクリプトの中で sys.exit(3) | 3 | — |
スクリプトが落ちても、そもそもスクリプトのファイルが見つからなくても、Blenderは「成功」を返します。 ログにはちゃんと書かれています(フォルダの部分は … で省略しました)。
OSError: Python file "C:\…\no_such_file.py" could not be opened: No such file or directory
Blender 5.2.2 LTS (hash d13f752e3b9c built 2026-09-15 01:37:04)

Blender quitただしこのあとの終了コードは0です。ファイル名を1文字打ち間違えたバッチを夜中に回すと、何もしないまま「正常終了」が返ってきます。公式マニュアルでも、--python-exit-code は「Pythonの例外が起きたときに返す終了コードを設定する(0なら無効)」と説明されており、既定は0です。
100個中1個だけ壊れていたら
もっと実務に近い形でも試しました。100個の元データのうち37番だけを、中身が glb ではない壊れたファイルに差し替えます。スクリプトは2通り用意しました。
| 書き方 | 終了コード | 書き出せた数 |
|---|---|---|
| 素朴なループ(try/except なし・既定のまま) | 0 | 37個(38個目以降は1個も作られない) |
素朴なループ+--python-exit-code 1 | 1 | 37個 |
1個ずつ try/except +最後に sys.exit | 1 | 99個 |
いちばん上の行がこの記事でいちばん怖い結果です。63個が作られていないのに「成功」。ログの途中に1行だけ、こう出ています。
RuntimeError: Error: Bad glTF: json error: Expecting value: line 1 column 1 (char 0)ここから分かるのは、終了コードを正しくするには2つのことを両方やる必要があるということです。
- 1個の失敗でループ全体を止めない(1個ずつ try/except で包んで、失敗を数える)
- 最後に、失敗の数に応じて
sys.exit(1)を自分で返す。書き忘れに備えて--python-exit-code 1も付けておく
fails = 0
for i, name in enumerate(files):
    try:
        convert_one(name)          # 読み込み → 加工 → 書き出し
        ok = 1
    except Exception as e:
        fails += 1
        ok = 0
        traceback.print_exc()      # ログには残す
    writer.writerow([i, name, ok]) # ★1個ごとに ok 列を記録する

# ★これを書かないと、1個失敗しても終了コードは0のまま
sys.exit(1 if fails else 0)
【実験3・両OS】きちんと片付けるほど、100個が1個になる
再現:runner.py --only e3(out/e3_summary.csv。1個ごとのメモリは out/e3/*/log.csv)
100個を1つのBlenderで回すと、読み込んだものがどんどん溜まっていきます。そこで1個処理するごとに片付けるわけですが、その片付け方を4通り、書き出すファイル名の決め方を2通りにして、全部の組み合わせを回しました。
| 片付け方 | やること |
|---|---|
| none | 何も消さない |
| objects | 読み込んだオブジェクトだけ消す(bpy.data.objects.remove)=よく見かける書き方 |
| purge | オブジェクトを消したうえで、使われなくなったデータも掃除する(orphans_purge) |
| reset | 1個ごとに read_factory_settings で空のシーンに戻す |
ファイル名は「読み込んだオブジェクトの名前から作る」(obj.name + ".glb")と「元のファイル名から作る」の2通りです。結果がこちらです(Windows・テクスチャ2048px。512pxでも、Macでも、個数は同じでした)。
| 片付け方 | 名前の決め方 | 書き出せた数 | メモリの増え方 | 終了コード |
|---|---|---|---|---|
| none | オブジェクト名 | 100 | +2,568MB | 0 |
| objects | オブジェクト名 | 1(上書き99回) | +2,541MB | 0 |
| purge | オブジェクト名 | 1(上書き99回) | +194MB | 0 |
| reset | オブジェクト名 | 1(上書き99回) | +212MB | 0 |
| none | 元ファイル名 | 100 | +2,574MB | 0 |
| objects | 元ファイル名 | 100 | +2,506MB | 0 |
| purge | 元ファイル名 | 100 | +224MB | 0 |
| reset | 元ファイル名 | 100 | +202MB | 0 |
予想と逆のことが2つ起きました。
1つ目。片付けをした3通りは、オブジェクト名でファイル名を作ると100個が1個になりました。 何も片付けない none だけが、偶然うまくいっています。512px・2048pxの16通りとも、終了コードは0・失敗0件なので、出力フォルダを数えない限り気づけません。
2つ目。「オブジェクトだけ消す」は、メモリの上では何もしないのと同じでした(Windowsで +2,541MB 対 +2,568MB、Macでも +2,356MB 対 +2,400MB)。メッシュ・マテリアル・画像が100個ずつ残っていたからです。
なぜ片付けると上書きされるのか
理由は Blender の名前の付け方にあります。同じ種類のデータに同じ名前は付けられないので、Model がすでにあると、次に来たものは Model.001 になります。
片付けると Model という名前が空くので、次に読み込んだものがまた Model を名乗ります。きれいに片付けるほど名前がぶつかり、同じファイル名に書き続けるわけです。逆に片付けないと Model.001〜Model.099 と名前がずれていくので、たまたま100個そろいます。
対策は簡単で、ファイル名は元のファイル名から作ることです。Blenderの中の名前は、いつ・何と一緒に読み込んだかで変わってしまうので、ファイル名の材料にしてはいけません。
メモリは「どこまで消したか」で決まる
1個処理するたびに、Blender がどれだけメモリを使っているかを記録しました(Windows・テクスチャ2048px)。
none と objects はほぼ重なって、1個あたり約26MBずつ増えていきます。読み込んだ1個ぶん(2048×2048のテクスチャを含む)が、まるごと残っていくわけです。purge と reset は300〜500MBの間で平らでした。
100個なら2.8GBで済みますが、1,000個なら単純計算で26GB近くになります。「途中で急に遅くなった」「数百個目で落ちた」ときは、まずこれを疑うのがよさそうです。
purge と reset の違いは時間でした。reset は毎回シーンを作り直すので、2048pxで 13.5秒 対 10.5秒、512pxでは 7.8秒 対 4.7秒と遅くなります。確実さは reset が上ですが、ふだんは purge で足ります。
# 1個処理し終わったら
for o in new_objects:
    bpy.data.objects.remove(o, do_unlink=True)   # オブジェクトを消す
bpy.data.orphans_purge(do_recursive=True)        # ★使われなくなったメッシュ・画像も消す
なお do_recursive=True を付けないと、「消したことで新しく孤立したデータ」(マテリアルが消えて孤立した画像など)が残ります。
【実験4・Windows】1回の起動で回すか、1個ずつ起動し直すか、並列にするか
再現:runner.py --only e4(out/e4_strategy.csv。サムネイルは out/e4/*/items/)
ここからは変換のついでに 256×256のサムネイルを焼きます。GPUを使うので Windows(RTX 3060)だけで測りました。回し方は4通りです。
- single … 1つのBlenderで100個
- per_item … 100個それぞれでBlenderを起動し直す(シェルのループで1個ずつ渡す、よくある形)
- par2 / par4 … Blenderを2本/4本同時に走らせて、100個を分け合う
並列は、convert.py の --start と --n で担当を分けて、Blenderを同時に起動しています(runner.py の e4() がこれを行います)。4本なら次の4つを同時に走らせるのと同じです。
blender -b --factory-startup --python convert.py -- --src out/src --start 0  --n 25 --render cycles --out out/par4
blender -b --factory-startup --python convert.py -- --src out/src --start 25 --n 25 --render cycles --out out/par4
blender -b --factory-startup --python convert.py -- --src out/src --start 50 --n 25 --render cycles --out out/par4
blender -b --factory-startup --python convert.py -- --src out/src --start 75 --n 25 --render cycles --out out/par4
1個ずつ起動し直す方式は、EEVEEで19.1倍、Cyclesで6.3倍遅くなりました。 EEVEEの per_item は1個あたり2.92秒かかっていますが、Blenderの中で実際に処理していたのは約1.17秒だけです。残りの約1.75秒は起動の費用で、実験1の1.59秒とほぼ一致します。Windows は起動が Mac の約3.5倍遅いので、この方式の損がそのまま大きく出ます。
並列は効きました。Cyclesは4本で2.05倍です。ただし1枚あたりのレンダー時間は 0.39秒 → 0.69秒 に伸びていて、4本がGPUを取り合っているのが分かります。4倍にはなりません。
EEVEEとCyclesで同じ品物を焼いた結果も並べておきます。サムネイル程度なら、見た目の差はほとんどありません。
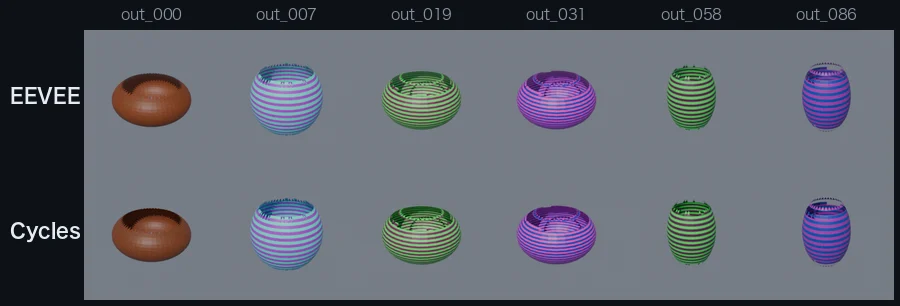
並列の初回だけ、12〜16秒止まることがあった
実は1回目の計測では、EEVEEの並列は1本で回すより遅いという結果でした(par2 20.7秒・par4 22.3秒 対 single 15.3秒)。ログを見ると、同時に立ち上げた一部のBlenderで最初の1枚だけが12〜16秒止まっていました(par2では2本中1本、par4では4本中2本)。
同じ品物を1個ずつ焼くと0.67秒なので、品物のせいではありません。直後に測り直すと、6回とも一度も止まらず、single 15.3秒 → par2 10.5秒 → par4 8.8秒 と素直に速くなりました。計測の前にウォームアップを1回(1本だけ)入れていたのですが、並列で同時に立ち上げたときの初回の準備までは温まりきらないことがあるようです。原因がシェーダの準備の取り合いなのかどうかまでは特定できていません。記事の数字は測り直した値を使っています。
初回の準備はマシンごとにかかる
Mac(Blender 5.2.1)で初めて Cycles(Metal)を使ったときは、最初の1回だけ126秒かかり、2回目は1.7秒でした。GPU向けのプログラムを準備して保存するためです。5.2.2 に上げた後は、初回から2.2秒で済みました(準備した結果が使い回された)(p976 でも Windows の EEVEE で同じことが起きました)。一括処理の所要時間を見積もるときは、2回目以降の数字を使うのが安全です。
【実験5・両OS】画面なしで動かない操作 ── 画面ありのほうが失敗が多い
再現:runner.py --only e5(out/e5_probe_*.csv。Blenderの画面が2回、一瞬開いて閉じます)
画面が無いと動かない操作があるのは想像がつきます。そこで16個の操作を、次の3通りで試しました。
- 画面なし(
-b) - 画面あり・すぐ実行(
-bを付けずに--pythonを渡す) - 画面あり・2秒待ってから実行(画面ができあがるのを待つ)
| 操作 | 画面なし | 画面あり・すぐ | 画面あり・待つ |
|---|---|---|---|
| 選択中のオブジェクトを読む | ○ | ✕ | ○ |
立方体を追加(primitive_cube_add) | ○ | ✕ | ○ |
| モディファイアを適用 | ○ | ✕ | ○ |
| 編集モードで細分化 | ○ | ✕ | ○ |
レンダリング(render.render) | ○ | ○ | ○ |
ビューポートのまま撮る(render.opengl) | ✕ | ✕ | ○ |
3Dビューを全体表示(view3d.view_all) | ✕ | ✕ | ○ |
| 画面のスクリーンショット | ✕ | ✕ | ○ |
| .blend に保存 | ○ | ○ | ○ |
| glTFで書き出し | ○ | ✕ | ○ |
| FBXで書き出し | ○ | ○ | ○ |
元に戻す(ed.undo) | ✕ | ✕ | ✕ |
| 成功した数(16個中) | 11 | 6 | 14 |
※16個のうち、状態とパスを確かめるだけの3つ(全条件で成功)と、「areaだけ渡す」版(全条件で失敗・下で説明)は表から省いています。
画面ありで起動したのに、画面なしより失敗が増えました。 --python で渡したスクリプトは、ウィンドウの中身ができあがる前に走ってしまうからです。このときはウィンドウ自体はあるのに、画面の配置(screen)がまだ空でした。
AttributeError: 'Context' object has no attribute 'active_object'もう1つ面白かったのが、glTFは失敗してFBXは成功したことです。glTFの書き出し処理が、内部で「選択中のオブジェクト」を読みに行って落ちていました。書き出し形式によって、同じタイミングで動いたり動かなかったりするわけです。
画面が必要な操作をスクリプトから呼ぶには
画面ありで確実に動かすには、2つ必要でした。
- タイマー(
bpy.app.timers)で実行を後ろにずらす … 画面ができあがってから走らせる - どの区画で操作するかを明示する … ⚠タイマーの中では、コンテキストにウィンドウが入っていない。ずらすだけでは結果が変わらなかった
import bpy

def later():
    win = bpy.context.window_manager.windows[0]
    area = next(a for a in win.screen.areas if a.type == "VIEW_3D")
    region = next(r for r in area.regions if r.type == "WINDOW")
    # ★4つとも渡す(area だけだと "Expected a view3d region" で落ちる)
    with bpy.context.temp_override(window=win, screen=win.screen, area=area, region=region):
        bpy.ops.view3d.view_all()
        bpy.ops.render.opengl(write_still=True)
    return None          # None を返すと1回で終わる

bpy.app.timers.register(later, first_interval=2.0)
このコードを later.py として保存し、-b を付けずに渡すと、Blenderの画面が開いてから2秒後に実行されます。
$B --factory-startup --python later.pyとはいえ、一括処理では画面に頼る操作を使わないのがいちばんです。ビューポートの撮影は render.render に置き換えられますし、オブジェクトの追加は bpy.data.meshes.new と bpy.data.objects.new で、選択状態に頼らず書けます。GUIでは動いていたスクリプトが一括処理で落ちたら、まずこの表の ✕ の行を使っていないかを見てください。
【実験6・両OS】パスと引数の順番
再現:runner.py --only e6(out/e6_paths.csv)
最後に、出力先の指定まわりです。
| 試したこと | 結果 | 終了コード |
|---|---|---|
保存していないシーンで //out.png に書く | 保存に失敗(No such file or directory) | 0 |
保存した .blend で -o //frames/f_#### -f 1 | .blend の隣の frames/ に出た | 0 |
-f 1 の後ろに -o を書く | -o が効かない。Mac は /tmp/、Windows は C:\tmp\ に書かれた | 0 |
| 日本語を含むフォルダで変換(10個) | 10個とも成功(Mac・Windowsとも) | 0 |
// は「.blend ファイルのある場所から見て」という意味なので、保存していないシーンでは基準が無く、書き出しに失敗します。それでも終了コードは0でした。
引数の順番は、公式マニュアルに例付きで書かれています。blender -b test.blend -f 1 -o /tmp は、先にレンダリングが走ってから出力先が設定されるので、指定した場所には出ません。さらに -o を .blend より前に書くと、今度は .blend を読み込んだときに出力先が上書きされます。正しい順番は「.blend → -o → -f」です。
blender -b scene.blend -o //frames/f_#### -F PNG -f 1    # ○ .blend の隣の frames/ に出る
blender -b scene.blend -f 1 -o //late/f_####             # ✕ -o が効かず、既定の /tmp/ に出る
Windows では、既定の出力先 /tmp/ が Cドライブ直下の C:\tmp\ として扱われ、無ければフォルダごと作られます。検証に使ったWindows機には、以前の検証で作られた C:\tmp がすでにありました。同じ落とし穴を前にも踏んでいて、気づいていなかったことになります😳
日本語を含むフォルダは、今回の範囲(Blender 5.2・Pythonからパスを渡す形)では両OSとも問題ありませんでした。
【おまけ・Windows】計測するコード自体が、黙って0を返していた
この記事の主題そのものが、計測するコードでも起きました。実験3のメモリは、Blenderの中から Windows の関数 GetProcessMemoryInfo を呼んで測っています。最初の計測では、100個×16通りのメモリがすべて 0.0MB でした(上の実行画面の rss 0.0->0.0)。
原因は、Python から C の関数を呼ぶ仕組み(ctypes)で型を指定していなかったことです。64bitの Windows では「自分のプロセス」を表す値(-1)が途中で壊れ、関数は失敗(エラー番号6=ハンドルが不正)を返していました。その戻り値を見ていなかったので、空の結果(0)をそのまま返していたわけです。
# ✕ 型を書かない(Macでは表に出ない。64bitのWindowsで黙って0になる)
h = ctypes.windll.kernel32.GetCurrentProcess()
ctypes.windll.psapi.GetProcessMemoryInfo(h, ctypes.byref(pmc), pmc.cb)

# ○ 型を書き、失敗したら例外にする
k32 = ctypes.WinDLL("kernel32", use_last_error=True)
psapi = ctypes.WinDLL("psapi", use_last_error=True)
k32.GetCurrentProcess.restype = wintypes.HANDLE
psapi.GetProcessMemoryInfo.argtypes = [wintypes.HANDLE, ctypes.POINTER(PMC), wintypes.DWORD]
psapi.GetProcessMemoryInfo.restype = wintypes.BOOL
if not psapi.GetProcessMemoryInfo(k32.GetCurrentProcess(), ctypes.byref(pmc), pmc.cb):
    raise ctypes.WinError(ctypes.get_last_error())
Macでは別の方法でメモリを取っていたので、この不具合は Windows で初めて表に出ました。型を直して実験3だけ測り直したのが、上の表の数字です(処理時間は直す前と±0.6秒以内で、メモリの取り方を直しても処理時間は変わっていません)。「0」は「何も起きなかった」なのか「測れなかった」なのか。この記事で何度も出てきた問いが、最後に自分のコードにも返ってきました。
【ここから整理】一括処理のひな形とチェックリスト
6つの実験で分かったことを、そのまま使えるひな形にまとめます。
# convert_all.py
# 使い方: blender -b --factory-startup --python-exit-code 1 --python convert_all.py -- --src 元フォルダ --out 出力フォルダ
import bpy, csv, os, sys, argparse, traceback

def args():
    a = sys.argv[sys.argv.index("--") + 1:] if "--" in sys.argv else []
    p = argparse.ArgumentParser()
    p.add_argument("--src", required=True)
    p.add_argument("--out", required=True)
    return p.parse_args(a)

def main():
    a = args()
    src, out = os.path.abspath(a.src), os.path.abspath(a.out)   # ★ // や相対パスに頼らない
    os.makedirs(out, exist_ok=True)
    files = sorted(f for f in os.listdir(src) if f.endswith(".glb"))
    bpy.ops.wm.read_factory_settings(use_empty=True)

    fails = 0
    with open(os.path.join(out, "log.csv"), "w", newline="", encoding="utf-8") as f:
        w = csv.writer(f)
        w.writerow(["file", "ok", "error"])
        for name in files:
            try:
                before = set(bpy.data.objects)
                bpy.ops.import_scene.gltf(filepath=os.path.join(src, name))
                new = [o for o in bpy.data.objects if o not in before]

                # --- ここで加工する(選択状態に頼らず、new を直接触る) ---

                bpy.ops.object.select_all(action="DESELECT")
                for o in new:
                    o.select_set(True)
                stem = os.path.splitext(name)[0]                  # ★名前は元ファイルから作る
                bpy.ops.export_scene.gltf(filepath=os.path.join(out, stem + ".glb"),
                                          export_format="GLB", use_selection=True)
                w.writerow([name, 1, ""])
            except Exception as e:
                fails += 1
                traceback.print_exc()
                w.writerow([name, 0, f"{type(e).__name__}: {e}"])
            finally:
                for o in [o for o in bpy.data.objects if o not in before]:
                    bpy.data.objects.remove(o, do_unlink=True)
                bpy.data.orphans_purge(do_recursive=True)         # ★メッシュ・画像まで消す

    written = len([x for x in os.listdir(out) if x.endswith(".glb")])
    print(f"files={len(files)} fails={fails} written={written}")
    sys.exit(1 if fails or written != len(files) - fails else 0)  # ★数が合わなければ失敗

main()
動かし方は convert.py と同じです(Macで、正常な100個 → 終了コード0・100個、37番を壊した100個 → 終了コード1・99個、になることを確かめています)。
$B -b --factory-startup --python-exit-code 1 --python convert_all.py -- --src out/src --out out/all
echo $?最後の1行では、失敗の数だけでなく書き出されたファイルの数も確かめています。実験3の上書きは、失敗0件のまま起きたからです。
| 確かめること | やらないと起きること(この記事の実験) |
|---|---|
--python-exit-code 1 を付け、最後に自分でも sys.exit | 落ちても・ファイルが無くても成功扱い(実験2) |
1個ずつ try/except で包み、ok 列を残す | 37個目で止まり、残り63個が作られない(実験2) |
| 出力の数を数える | 100個が1個に上書きされても気づかない(実験3) |
| ファイル名は元ファイル名から作る | Blender内の名前がぶつかって上書き(実験3) |
orphans_purge(do_recursive=True) まで書く | 2048pxで +2.5GB、1,000個なら20GB超(実験3) |
| 1回の起動でまとめて回す(必要なら並列) | Windowsで19倍遅い(実験4) |
画面に頼る操作(view3d.*・render.opengl など)を使わない | 画面なしで落ちる。画面ありでも起動直後は落ちる(実験5) |
パスは絶対パスに。-o は .blend の後・-f の前 | 保存失敗・C:\tmp\ に出力(実験6) |
まとめ
- Blenderの一括処理は
blender -b --factory-startup --python スクリプト -- 引数が基本形。--より後ろがスクリプトへの引数 - ★既定では、スクリプトが落ちても・ファイルが無くても終了コードは0。
--python-exit-code 1と自前のsys.exitの両方で守る - ★きちんと片付けるほど、Blender内の名前がぶつかって100個が1個になる。ファイル名は元ファイル名から作り、出力の数を数える
- ★オブジェクトだけ消してもメモリは減らない。
orphans_purge(do_recursive=True)まで書く - 1個ずつ起動し直すのは遅い(Windowsで起動1.6秒・EEVEEで19倍)。1回の起動でまとめ、速くしたいなら並列(Cycles 4本で2.05倍)
- 画面ありで
--pythonを渡すと、起動直後は画面なしより失敗が多い。画面に頼る操作は一括処理に入れない - 引数は左から順に実行される。
.blend → -o → -fの順に書く
画面を開かない処理は、うまくいったときも失敗したときも、同じように静かに終わります。終了コード・出力の数・メモリの3つを自分で確かめる仕組みを、最初から入れておくのがいちばんの近道でした。
実測した環境
Mac:Apple M4 / メモリ32GB / macOS 26.6.2 / Blender 5.2.2 LTS(hash d13f752e3b9c)
Windows:Ryzen 7 7840HS / メモリ32GB / Windows 11 Pro 25H2 / GeForce RTX 3060 12GB(ドライバ 616.92)/ Blender 5.2.2 LTS(hash d13f752e3b9c)
両OSとも、執筆時点の最新版 Blender 5.2.2 LTS にそろえて測りました(Macは最初 5.2.1 で測ってしまい、5.2.2 で測り直しています。結果は同じでした)。計測日は 2026-09-22 です。
【付録】スクリプト全文
実験に使った5つのスクリプトです。クリックすると開きます。p998_scripts.zip にも同じものが入っています。
make_sources.py … 材料づくり(Blenderの中)・78行
# -*- coding: utf-8 -*-
"""
p998 材料づくり: 変換の元になる glb を100個つくる。Blenderの中で動く。

  blender -b --factory-startup --python make_sources.py -- --n 100 --tex 512 --out out/src

★現場でよくある形に寄せている:
  - どのファイルも中身の名前が同じ(オブジェクト "Model"・メッシュ "Model"・マテリアル "Material")
  - 1個ごとにテクスチャ画像(--tex で一辺のピクセル数)を1枚埋め込む
"""
import bpy
import math
import os
import random
import sys


def args():
    import argparse
    a = sys.argv[sys.argv.index("--") + 1:] if "--" in sys.argv else []
    p = argparse.ArgumentParser()
    p.add_argument("--n", type=int, default=100)
    p.add_argument("--tex", type=int, default=512)
    p.add_argument("--out", required=True)
    return p.parse_args(a)


def one(i, tex, out):
    bpy.ops.wm.read_factory_settings(use_empty=True)
    rnd = random.Random(i)
    bpy.ops.mesh.primitive_uv_sphere_add(segments=32 + rnd.randint(0, 32), ring_count=16 + rnd.randint(0, 16),
                                         radius=1.0)
    obj = bpy.context.object
    obj.name = "Model"
    obj.data.name = "Model"
    obj.scale = (1, 1, rnd.uniform(0.5, 2.0))

    img = bpy.data.images.new("Texture", tex, tex)
    # 1個ずつ違う色の縞模様+ノイズ(中身が同じだと圧縮されてメモリ差が見えにくい)
    import numpy as np
    g = np.random.default_rng(i)
    c = g.random(3)
    band = ((np.arange(tex) // (4 + i % 13)) % 2)[:, None]
    px = np.empty((tex, tex, 4), dtype=np.float32)
    noise = g.random((tex, tex)) * 0.15
    px[..., 0] = c[0] * band + noise
    px[..., 1] = c[1] * (1 - band) + noise
    px[..., 2] = c[2] + noise
    px[..., 3] = 1.0
    px = px.ravel()
    img.pixels.foreach_set(px)
    img.pack()

    mat = bpy.data.materials.new("Material")
    mat.use_nodes = True
    nt = mat.node_tree
    tn = nt.nodes.new("ShaderNodeTexImage")
    tn.image = img
    nt.links.new(tn.outputs["Color"], nt.nodes["Principled BSDF"].inputs["Base Color"])
    obj.data.materials.append(mat)

    path = os.path.join(out, f"src_{i:03d}.glb")
    bpy.ops.export_scene.gltf(filepath=path, export_format="GLB")
    return path


def main():
    a = args()
    out = os.path.abspath(a.out)
    os.makedirs(out, exist_ok=True)
    for i in range(a.n):
        p = one(i, a.tex, out)
        print(f"[src] {i:03d} {os.path.getsize(p)} bytes")
    sys.exit(0)


if __name__ == "__main__":
    main()
convert.py … 変換の本体(Blenderの中)・255行
# -*- coding: utf-8 -*-
"""
p998 変換の本体(実験2・3・4・6で使用)。Blenderの中で動く。
100個の glb を「読み込む → 面を半分に減らす → glb で書き出す(→ サムネイルを焼く)」を1つのBlenderで回す。

  blender -b --factory-startup --python-exit-code 1 --python convert.py -- --src 元フォルダ --out 出力フォルダ

--cleanup   none(消さない)/ objects(オブジェクトだけ消す)/ purge(孤立データも掃除)/ reset(毎回空のシーンに戻す)
--name-from object(オブジェクト名から出力名を作る)/ source(元ファイル名から作る)
--render    none / workbench / eevee / cycles(サムネイルを焼く)  --res 256 --samples 16
--n / --start  一部だけ処理する(例: --start 37 --n 1)
--naive     try/except も sys.exit も使わない素朴な書き方(失敗したらそこで止まる)

出力: <out>/items/*.glb(*.png)と <out>/log.csv(1個ごとの ok・時間・メモリ・データ数・名前)
"""
import bpy
import csv
import math
import os
import sys
import time
import traceback


# ------------------------------------------------------------------ 小道具

def rss_mb():
    """いまのプロセスの常駐メモリ(MB)。Windowsでは resource が無いので ctypes で取る"""
    if sys.platform == "win32":
        import ctypes
        from ctypes import wintypes

        class PMC(ctypes.Structure):
            _fields_ = [("cb", wintypes.DWORD), ("PageFaultCount", wintypes.DWORD),
                        ("PeakWorkingSetSize", ctypes.c_size_t), ("WorkingSetSize", ctypes.c_size_t),
                        ("QuotaPeakPagedPoolUsage", ctypes.c_size_t), ("QuotaPagedPoolUsage", ctypes.c_size_t),
                        ("QuotaPeakNonPagedPoolUsage", ctypes.c_size_t), ("QuotaNonPagedPoolUsage", ctypes.c_size_t),
                        ("PagefileUsage", ctypes.c_size_t), ("PeakPagefileUsage", ctypes.c_size_t)]
        pmc = PMC()
        pmc.cb = ctypes.sizeof(PMC)
        # ★型を指定しないと 64bit で疑似ハンドル(-1)が int として渡され、ERROR_INVALID_HANDLE で黙って失敗→0.0 になる
        k32 = ctypes.WinDLL("kernel32", use_last_error=True)
        psapi = ctypes.WinDLL("psapi", use_last_error=True)
        k32.GetCurrentProcess.restype = wintypes.HANDLE
        psapi.GetProcessMemoryInfo.argtypes = [wintypes.HANDLE, ctypes.POINTER(PMC), wintypes.DWORD]
        psapi.GetProcessMemoryInfo.restype = wintypes.BOOL
        if not psapi.GetProcessMemoryInfo(k32.GetCurrentProcess(), ctypes.byref(pmc), pmc.cb):
            raise ctypes.WinError(ctypes.get_last_error())
        return pmc.WorkingSetSize / 1048576
    # macOS: task_info で「いまの」常駐量を取る(ru_maxrss は最大値なので減らない)
    try:
        import ctypes
        import ctypes.util
        libc = ctypes.CDLL(ctypes.util.find_library("c"))

        class TaskBasicInfo(ctypes.Structure):
            _fields_ = [("virtual_size", ctypes.c_uint64), ("resident_size", ctypes.c_uint64),
                        ("resident_size_max", ctypes.c_uint64), ("user_time", ctypes.c_uint64),
                        ("system_time", ctypes.c_uint64), ("policy", ctypes.c_int),
                        ("suspend_count", ctypes.c_int)]
        MACH_TASK_BASIC_INFO = 20
        info = TaskBasicInfo()
        count = ctypes.c_uint(ctypes.sizeof(info) // 4)
        libc.mach_task_self.restype = ctypes.c_uint
        r = libc.task_info(libc.mach_task_self(), MACH_TASK_BASIC_INFO, ctypes.byref(info), ctypes.byref(count))
        if r == 0:
            return info.resident_size / 1048576
    except Exception:
        pass
    import resource
    return resource.getrusage(resource.RUSAGE_SELF).ru_maxrss / 1048576


def setup_render(args):
    sc = bpy.context.scene
    sc.render.resolution_x = args.res
    sc.render.resolution_y = args.res
    sc.render.resolution_percentage = 100
    sc.render.image_settings.file_format = "PNG"
    if args.render == "workbench":
        sc.render.engine = "BLENDER_WORKBENCH"
        sc.display.shading.color_type = "MATERIAL"
    elif args.render == "eevee":
        sc.render.engine = "BLENDER_EEVEE"
        sc.eevee.taa_render_samples = args.samples
    elif args.render == "cycles":
        sc.render.engine = "CYCLES"
        sc.cycles.samples = args.samples
        sc.cycles.use_denoising = True
        try:
            prefs = bpy.context.preferences.addons["cycles"].preferences
            for t in ("OPTIX", "CUDA", "METAL", "HIP"):
                try:
                    prefs.compute_device_type = t
                    break
                except TypeError:
                    continue
            prefs.get_devices()
            for d in prefs.devices:
                d.use = d.type != "CPU"
            sc.cycles.device = "GPU"
        except Exception:
            traceback.print_exc()


def ensure_camera_light():
    sc = bpy.context.scene
    if sc.camera is None or sc.camera.name not in bpy.data.objects:
        cam = bpy.data.objects.new("cam", bpy.data.cameras.new("cam"))
        sc.collection.objects.link(cam)
        cam.location = (9, -9, 7)
        cam.rotation_euler = (math.radians(65), 0, math.radians(45))
        cam.data.clip_end = 1000
        sc.camera = cam
    if "sun" not in bpy.data.objects:
        sun = bpy.data.objects.new("sun", bpy.data.lights.new("sun", "SUN"))
        sun.data.energy = 3
        sun.rotation_euler = (math.radians(40), 0, math.radians(30))
        sc.collection.objects.link(sun)


def frame_object(obj):
    """カメラを、いま作った1個がちょうど収まる位置へ動かす(サムネイル用)"""
    from mathutils import Vector
    sc = bpy.context.scene
    bpy.context.view_layer.update()
    pts = [obj.matrix_world @ Vector(c) for c in obj.bound_box]
    center = sum(pts, Vector()) / 8
    size = max((max(p[k] for p in pts) - min(p[k] for p in pts)) for k in range(3))
    d = Vector((1.0, -1.0, 0.75)).normalized()
    cam = sc.camera
    cam.location = center + d * size * 2.4
    cam.rotation_euler = (-d).to_track_quat("-Z", "Y").to_euler()
    if sc.world is None:
        sc.world = bpy.data.worlds.new("world")
    sc.world.color = (0.18, 0.2, 0.24)
    if sc.world.use_nodes and "Background" in sc.world.node_tree.nodes:
        sc.world.node_tree.nodes["Background"].inputs["Color"].default_value = (0.18, 0.2, 0.24, 1)


# ------------------------------------------------------------------ 本体

def args():
    import argparse
    a = sys.argv[sys.argv.index("--") + 1:] if "--" in sys.argv else []
    p = argparse.ArgumentParser()
    p.add_argument("--src", required=True)
    p.add_argument("--n", type=int, default=100)
    p.add_argument("--start", type=int, default=0)
    p.add_argument("--cleanup", default="purge", choices=["none", "objects", "purge", "reset"])
    p.add_argument("--name-from", default="object", choices=["object", "source"])
    p.add_argument("--render", default="none", choices=["none", "workbench", "eevee", "cycles"])
    p.add_argument("--res", type=int, default=256)
    p.add_argument("--samples", type=int, default=16)
    p.add_argument("--out", required=True)
    p.add_argument("--tag", default="")
    p.add_argument("--naive", action="store_true",
                   help="try/except も sys.exit も書かない、素朴な書き方(失敗したらそこでループが止まる)")
    return p.parse_args(a)


def main():
    a = args()
    src = os.path.abspath(a.src)
    out = os.path.abspath(a.out)
    items = os.path.join(out, "items")
    os.makedirs(items, exist_ok=True)
    files = sorted(f for f in os.listdir(src) if f.endswith(".glb"))[a.start: a.start + a.n]

    bpy.ops.wm.read_factory_settings(use_empty=True)
    print(f"[p998] convert blender {bpy.app.version_string} platform={sys.platform} "
          f"cleanup={a.cleanup} name_from={a.name_from} render={a.render} files={len(files)}")

    log_path = os.path.join(out, f"log_{a.start:03d}.csv" if a.start or a.n < 100 else "log.csv")
    f = open(log_path, "w", newline="", encoding="utf-8")
    w = csv.writer(f)
    w.writerow(["tag", "i", "src", "ok", "sec_import", "sec_edit", "sec_export", "sec_render", "sec_total",
                "rss_mb", "n_objects", "n_meshes", "n_materials", "n_images", "obj_name", "mesh_name",
                "out_file", "overwrote", "error"])
    written = set()
    fails = 0
    t_all = time.perf_counter()
    for i, name in enumerate(files, start=a.start):
        t0 = time.perf_counter()
        r = dict(ok=0, sec_import="", sec_edit="", sec_export="", sec_render="", obj_name="", mesh_name="",
                 out_file="", overwrote="", error="")
        try:
            if a.render != "none":
                if i == a.start or a.cleanup == "reset":
                    setup_render(a)
                ensure_camera_light()
            before = set(bpy.data.objects)
            bpy.ops.import_scene.gltf(filepath=os.path.join(src, name))
            new = [o for o in bpy.data.objects if o not in before and o.type == "MESH"]
            obj = new[0]
            r["obj_name"], r["mesh_name"] = obj.name, obj.data.name
            t1 = time.perf_counter()

            # 手を加える: 面を半分に減らす(Decimate を適用)
            m = obj.modifiers.new("dec", "DECIMATE")
            m.ratio = 0.5
            bpy.context.view_layer.objects.active = obj
            bpy.ops.object.select_all(action="DESELECT")
            obj.select_set(True)
            bpy.ops.object.modifier_apply(modifier="dec")
            t2 = time.perf_counter()

            stem = obj.name if a.name_from == "object" else os.path.splitext(name)[0].replace("src_", "out_")
            outp = os.path.join(items, stem + ".glb")
            r["overwrote"] = int(outp in written)
            written.add(outp)
            bpy.ops.export_scene.gltf(filepath=outp, export_format="GLB", use_selection=True)
            r["out_file"] = os.path.basename(outp)
            t3 = time.perf_counter()

            if a.render != "none":
                for o in bpy.context.scene.objects:
                    if o.type == "MESH":
                        o.hide_render = (o is not obj)
                frame_object(obj)
                bpy.context.scene.render.filepath = os.path.join(items, stem + ".png")
                bpy.ops.render.render(write_still=True)
            t4 = time.perf_counter()
            r.update(ok=1, sec_import=round(t1 - t0, 4), sec_edit=round(t2 - t1, 4),
                     sec_export=round(t3 - t2, 4), sec_render=round(t4 - t3, 4))

            if a.cleanup in ("objects", "purge"):
                for o in new:
                    bpy.data.objects.remove(o, do_unlink=True)
            if a.cleanup == "purge":
                bpy.data.orphans_purge(do_recursive=True)
            if a.cleanup == "reset":
                bpy.ops.wm.read_factory_settings(use_empty=True)
        except Exception as e:
            if a.naive:
                f.close()
                raise
            fails += 1
            r["error"] = f"{type(e).__name__}: {e}".replace("\n", " ")[:300]
            traceback.print_exc()
        w.writerow([a.tag, i, name, r["ok"], r["sec_import"], r["sec_edit"], r["sec_export"], r["sec_render"],
                    round(time.perf_counter() - t0, 4), round(rss_mb(), 1), len(bpy.data.objects),
                    len(bpy.data.meshes), len(bpy.data.materials), len(bpy.data.images),
                    r["obj_name"], r["mesh_name"], r["out_file"], r["overwrote"], r["error"]])
        f.flush()
    f.close()
    n_out = len([x for x in os.listdir(items) if x.endswith(".glb")])
    print(f"[p998] done files={len(files)} fails={fails} out_glb={n_out} sec={time.perf_counter() - t_all:.2f}")
    if not a.naive:
        # ★これを書かないと、1個失敗しても終了コードは0(成功)のまま
        sys.exit(1 if fails else 0)


if __name__ == "__main__":
    main()
probe_ops.py … 実験5の16操作(Blenderの中)・197行
# -*- coding: utf-8 -*-
"""
p998 実験5: 16個の操作を1つずつ試し、動いたかどうかを CSV に残す。Blenderの中で動く。

  画面なし          : blender -b --factory-startup --python probe_ops.py -- --out out/probe_bg.csv
  画面あり・すぐ実行 : blender --factory-startup --python probe_ops.py -- --out out/probe_gui.csv --quit
  画面あり・待って実行: blender --factory-startup --python probe_ops.py -- --out out/probe_defer.csv --defer --quit
  (画面ありの2つは、Blenderのウィンドウが一瞬開いて自動で閉じる)
"""
import bpy
import csv
import os
import sys
import tempfile
import traceback


def args():
    a = sys.argv[sys.argv.index("--") + 1:] if "--" in sys.argv else []
    out = a[a.index("--out") + 1] if "--out" in a else "probe.csv"
    return os.path.abspath(out), ("--quit" in a), ("--defer" in a)


TMP = tempfile.mkdtemp(prefix="p998_")


def fresh():
    bpy.ops.wm.read_factory_settings(use_empty=False)   # 既定の立方体・カメラ・ライトがある状態


def c_active():
    o = bpy.context.active_object
    return f"active={o.name if o else None} / selected={len(bpy.context.selected_objects)}"


def c_add_cube():
    bpy.ops.mesh.primitive_cube_add(location=(3, 0, 0))
    return f"added {bpy.context.object.name}"


def c_modifier_apply():
    o = bpy.data.objects["Cube"]
    m = o.modifiers.new("sub", "SUBSURF")
    m.levels = 2
    bpy.context.view_layer.objects.active = o
    bpy.ops.object.modifier_apply(modifier="sub")
    return f"verts={len(o.data.vertices)}"


def c_editmode_subdivide():
    o = bpy.data.objects["Cube"]
    bpy.context.view_layer.objects.active = o
    bpy.ops.object.mode_set(mode="EDIT")
    bpy.ops.mesh.select_all(action="SELECT")
    bpy.ops.mesh.subdivide(number_cuts=2)
    bpy.ops.object.mode_set(mode="OBJECT")
    return f"verts={len(o.data.vertices)}"


def c_render_still():
    sc = bpy.context.scene
    sc.render.engine = "BLENDER_WORKBENCH"
    sc.render.resolution_x = sc.render.resolution_y = 64
    sc.render.filepath = os.path.join(TMP, "still.png")
    bpy.ops.render.render(write_still=True)
    return f"exists={os.path.exists(sc.render.filepath)}"


def c_render_opengl():
    sc = bpy.context.scene
    sc.render.resolution_x = sc.render.resolution_y = 64
    sc.render.filepath = os.path.join(TMP, "gl.png")
    bpy.ops.render.opengl(write_still=True)
    return f"exists={os.path.exists(sc.render.filepath)}"


def c_view3d_frame():
    bpy.ops.view3d.view_all()
    return "ok"


def c_view3d_override():
    win = bpy.context.window_manager.windows[0] if bpy.context.window_manager.windows else None
    if win is None:
        raise RuntimeError("window が1つも無い")
    area = next(a for a in win.screen.areas if a.type == "VIEW_3D")
    with bpy.context.temp_override(window=win, area=area):
        bpy.ops.view3d.view_all()
    return "ok(temp_override)"


def c_screenshot():
    p = os.path.join(TMP, "shot.png")
    bpy.ops.screen.screenshot(filepath=p)
    return f"exists={os.path.exists(p)}"


def c_save_as():
    p = os.path.join(TMP, "saved.blend")
    bpy.ops.wm.save_as_mainfile(filepath=p)
    return f"exists={os.path.exists(p)} / bpy.data.filepath={bpy.data.filepath}"


def c_relpath_unsaved():
    return f"abspath('//x.png')={bpy.path.abspath('//x.png')!r}"


def c_gltf_export():
    p = os.path.join(TMP, "a.glb")
    bpy.ops.export_scene.gltf(filepath=p, export_format="GLB")
    return f"bytes={os.path.getsize(p)}"


def c_fbx_export():
    p = os.path.join(TMP, "a.fbx")
    bpy.ops.export_scene.fbx(filepath=p)
    return f"bytes={os.path.getsize(p)}"


def c_undo():
    bpy.ops.ed.undo()
    return "ok"


def c_windows():
    wm = bpy.context.window_manager
    return f"windows={len(wm.windows)} / screen={bpy.context.screen}"


CASES = [
    ("状態: ウィンドウの数", c_windows),
    ("状態: アクティブ/選択", c_active),
    ("追加: primitive_cube_add", c_add_cube),
    ("モディファイア適用", c_modifier_apply),
    ("編集モードで細分化", c_editmode_subdivide),
    ("レンダリング: render.render", c_render_still),
    ("ビューポート撮影: render.opengl", c_render_opengl),
    ("3Dビュー操作: view3d.view_all", c_view3d_frame),
    ("3Dビュー操作(areaだけ渡す)", c_view3d_override),
    ("画面のスクショ: screen.screenshot", c_screenshot),
    ("未保存での // パス", c_relpath_unsaved),
    ("保存: save_as_mainfile", c_save_as),
    ("保存後の // パス", c_relpath_unsaved),
    ("書き出し: glTF", c_gltf_export),
    ("書き出し: FBX", c_fbx_export),
    ("元に戻す: ed.undo", c_undo),
]


def run(out, quit_after, mode):
    os.makedirs(os.path.dirname(out), exist_ok=True)
    rows = []
    if mode == "immediate":
        fresh()
    ctx = {}
    if mode == "defer":
        # ★タイマーの中では context に window が入っていない。3Dビューの区画を探して明示的に渡す
        win = bpy.context.window_manager.windows[0]
        area = next(a for a in win.screen.areas if a.type == "VIEW_3D")
        region = next(r for r in area.regions if r.type == "WINDOW")
        ctx = dict(window=win, screen=win.screen, area=area, region=region)
    for name, fn in CASES:
        try:
            if ctx:
                with bpy.context.temp_override(**ctx):
                    msg = fn()
            else:
                msg = fn()
            rows.append([name, 1, msg.replace("\n", " ")])
        except Exception as e:
            rows.append([name, 0, f"{type(e).__name__}: {str(e).strip()}".replace("\n", " ")[:300]])
        print(f"[probe] {rows[-1][1]} {name} :: {rows[-1][2]}")
    with open(out, "w", newline="", encoding="utf-8") as f:
        w = csv.writer(f)
        w.writerow(["case", "ok", "detail"])
        w.writerows(rows)
    print(f"[probe] background={bpy.app.background} mode={mode} version={bpy.app.version_string} -> {out}")
    if quit_after:
        # ★起動直後(--python の中)では quit_blender の poll も通らないので、os._exit で確実に終える
        sys.stdout.flush()
        os._exit(0)


def main():
    out, quit_after, defer = args()
    if defer and not bpy.app.background:
        # ★画面が出来上がってから実行する(--python の時点ではウィンドウもスクリーンもまだ無い)
        def later():
            run(out, quit_after, "defer")
            return None
        bpy.app.timers.register(later, first_interval=2.0)
    else:
        run(out, quit_after, "immediate")


if __name__ == "__main__":
    main()
err.py … 実験2のわざと落ちるスクリプト(Blenderの中)・5行
# p998 実験2: わざと例外で落ちるだけのスクリプト
#   blender -b --factory-startup --python err.py
import bpy
print("before error")
raise RuntimeError("わざと落とす")
runner.py … 全実験をまとめて回す(Blenderの外・Python 3)・408行
# -*- coding: utf-8 -*-
r"""
p998: 実験0〜6をまとめて回す。★Blenderの外で、ふつうの Python 3 で動かす(標準ライブラリだけ)。
make_sources.py / convert.py / probe_ops.py / err.py と同じフォルダに置いて実行する。

  Mac    : python3 runner.py --blender /Applications/Blender.app/Contents/MacOS/Blender
  Windows: python runner.py --blender "C:\Program Files\Blender Foundation\Blender 5.2\blender.exe"

  --only e1,e2    一部の実験だけ回す(既定は all)
  --quick         回数と個数を減らした短縮版(実験4はWorkbenchで6個だけ)
  --no-gui        画面ありの実験(実験5の2つ)を飛ばす

実験:
  e0 環境の申告               → out/env.txt
  e1 起動にかかる時間          → out/e1_startup.csv
  e2 失敗したときの終了コード   → out/e2_exitcode.csv
  e3 後片付けと名前(100個)   → out/e3_summary.csv(1個ごとは out/e3/*/log.csv)
  e4 1プロセス/1個ずつ/並列    → out/e4_strategy.csv(レンダリングあり)
  e5 画面なしで動かない操作     → out/e5_probe_*.csv
  e6 パス(// と日本語フォルダ) → out/e6_paths.csv

★Blenderの設定置き場は、このフォルダの blender_home/ に隔離する(普段の設定を汚さない)。
★どの実験も、失敗しても止めずに次へ進む。結果には必ず終了コードか ok 列を残す。
"""
import argparse
import csv
import os
import platform
import shutil
import subprocess
import sys
import time

HERE = os.path.dirname(os.path.abspath(__file__))
OUT = os.path.join(HERE, "out")

# Windowsの cp932 で print が落ちないように
try:
    sys.stdout.reconfigure(encoding="utf-8", errors="replace")
except Exception:
    pass


def log(msg):
    print(f"[runner] {time.strftime('%H:%M:%S')} {msg}", flush=True)


def run(cmd, logfile=None, cwd=None, env=None, timeout=3600):
    """コマンドを実行し、(終了コード, 秒, 出力) を返す。出力は utf-8 で読む(cp932で読まない)"""
    t0 = time.perf_counter()
    try:
        p = subprocess.run(cmd, cwd=cwd or HERE, env=env, stdout=subprocess.PIPE, stderr=subprocess.STDOUT,
                           timeout=timeout)
        rc = p.returncode
        text = p.stdout.decode("utf-8", errors="replace")
    except subprocess.TimeoutExpired as e:
        rc = "timeout"
        text = (e.stdout or b"").decode("utf-8", errors="replace")
    sec = time.perf_counter() - t0
    if logfile:
        os.makedirs(os.path.dirname(logfile), exist_ok=True)
        with open(logfile, "w", encoding="utf-8") as f:
            f.write(" ".join(f'"{c}"' if " " in c else c for c in cmd) + "\n\n" + text)
    return rc, sec, text


def user_env(isolated_home):
    """★eightの普段のBlender設定を汚さないよう、設定置き場を隔離する(消せば元通り)"""
    env = dict(os.environ)
    if isolated_home:
        env["BLENDER_USER_RESOURCES"] = isolated_home
    env["PYTHONUTF8"] = "1"
    return env


def write_csv(path, header, rows):
    os.makedirs(os.path.dirname(path), exist_ok=True)
    with open(path, "w", newline="", encoding="utf-8") as f:
        w = csv.writer(f)
        w.writerow(header)
        w.writerows(rows)


# ------------------------------------------------------------------ e0

def e0(B, env):
    lines = [f"platform: {platform.platform()}", f"machine: {platform.machine()}",
             f"python: {sys.version.split()[0]}", f"cpu_count: {os.cpu_count()}", f"blender_path: {B}"]
    rc, sec, txt = run([B, "-b", "--factory-startup", "--python-expr",
                        "import bpy,sys;print('BLVER',bpy.app.version_string);print('BLHASH',bpy.app.build_hash.decode())"],
                       env=env, timeout=300)
    for ln in txt.splitlines():
        if ln.startswith(("BLVER", "BLHASH")):
            lines.append(ln)
    if shutil.which("nvidia-smi"):
        _, _, g = run(["nvidia-smi", "--query-gpu=name,driver_version,memory.total", "--format=csv,noheader"],
                      timeout=60)
        lines.append("gpu(nvidia-smi): " + g.strip())
    if sys.platform == "darwin":
        _, _, g = run(["sysctl", "-n", "machdep.cpu.brand_string", "hw.memsize"], timeout=30)
        lines.append("cpu/mem: " + " / ".join(g.split()))
    # 空き容量
    du = shutil.disk_usage(HERE)
    lines.append(f"disk_free_GB: {du.free / 1e9:.1f}")
    os.makedirs(OUT, exist_ok=True)
    with open(os.path.join(OUT, "env.txt"), "w", encoding="utf-8") as f:
        f.write("\n".join(lines) + "\n")
    log("e0 " + " | ".join(lines))


# ------------------------------------------------------------------ e1 起動時間

def e1(B, env_iso, env_user, reps):
    rows = []
    cases = [
        ("factory", [B, "-b", "--factory-startup", "--python-expr", "pass"], env_iso),
        ("user_prefs", [B, "-b", "--python-expr", "pass"], env_user),
        ("factory_import_bpy_ops", [B, "-b", "--factory-startup", "--python-expr",
                                    "import bpy; bpy.ops.mesh.primitive_cube_add()"], env_iso),
    ]
    for name, cmd, env in cases:
        for k in range(reps + 1):
            rc, sec, _ = run(cmd, env=env, timeout=600,
                             logfile=os.path.join(OUT, "logs", f"e1_{name}_{k}.txt"))
            rows.append([name, k, "warmup" if k == 0 else "", rc, round(sec, 3)])
            log(f"e1 {name} #{k} rc={rc} {sec:.2f}s")
    write_csv(os.path.join(OUT, "e1_startup.csv"), ["case", "rep", "note", "exit", "sec"], rows)


# ------------------------------------------------------------------ e2 終了コード

def e2(B, env):
    rows = []
    cases = [
        ("script_raises_default", [B, "-b", "--factory-startup", "--python", "err.py"]),
        ("script_raises_exitcode1", [B, "-b", "--factory-startup", "--python-exit-code", "1", "--python", "err.py"]),
        ("expr_raises_default", [B, "-b", "--factory-startup", "--python-expr", "1/0"]),
        ("expr_raises_exitcode1", [B, "-b", "--factory-startup", "--python-exit-code", "1", "--python-expr", "1/0"]),
        ("missing_script_default", [B, "-b", "--factory-startup", "--python", "no_such_file.py"]),
        ("missing_script_exitcode1", [B, "-b", "--factory-startup", "--python-exit-code", "1",
                                      "--python", "no_such_file.py"]),
        ("missing_blend_default", [B, "-b", "no_such_file.blend", "--python-expr", "pass"]),
        ("script_sys_exit_3", [B, "-b", "--factory-startup", "--python-expr", "import sys; sys.exit(3)"]),
    ]
    for name, cmd in cases:
        rc, sec, txt = run(cmd, env=env, timeout=300, logfile=os.path.join(OUT, "logs", f"e2_{name}.txt"))
        tb = int("Traceback" in txt or "Error" in txt)
        rows.append([name, rc, tb, round(sec, 3)])
        log(f"e2 {name} rc={rc} error_in_log={tb}")

    # 100個のうち1個だけ壊れているとき(★壊れた1個は ok=0 で残り、プロセスの終了コードは1)
    src = os.path.join(OUT, "src")
    broken = os.path.join(OUT, "src_broken")
    if os.path.isdir(src):
        shutil.rmtree(broken, ignore_errors=True)
        shutil.copytree(src, broken)
        with open(os.path.join(broken, "src_037.glb"), "wb") as f:
            f.write(b"this is not a glb file")
        for name, extra in (("naive_one_broken_default", ["--naive"]),
                            ("naive_one_broken_exitcode1", ["--naive"]),
                            ("careful_one_broken_default", []),
                            ("careful_one_broken_exitcode1", [])):
            o = os.path.join(OUT, "e2_" + name)
            shutil.rmtree(o, ignore_errors=True)
            ec = ["--python-exit-code", "1"] if name.endswith("exitcode1") else []
            cmd = [B, "-b", "--factory-startup", *ec, "--python", "convert.py", "--",
                   "--src", broken, "--cleanup", "purge", "--name-from", "source", "--out", o, "--tag", name, *extra]
            rc, sec, txt = run(cmd, env=env, timeout=1800, logfile=os.path.join(OUT, "logs", f"e2_{name}.txt"))
            n_out = len([x for x in os.listdir(os.path.join(o, "items")) if x.endswith(".glb")]) \
                if os.path.isdir(os.path.join(o, "items")) else 0
            rows.append([name, rc, int("Traceback" in txt), round(sec, 3), n_out])
            log(f"e2 {name} rc={rc} out_glb={n_out}")
    write_csv(os.path.join(OUT, "e2_exitcode.csv"), ["case", "exit", "error_in_log", "sec", "out_glb"], rows)


# ------------------------------------------------------------------ 材料

def make_src(B, env, tex, name):
    d = os.path.join(OUT, name)
    if os.path.isdir(d) and len([x for x in os.listdir(d) if x.endswith(".glb")]) >= 100:
        return d
    rc, sec, _ = run([B, "-b", "--factory-startup", "--python", "make_sources.py", "--",
                      "--n", "100", "--tex", str(tex), "--out", d], env=env, timeout=3600,
                     logfile=os.path.join(OUT, "logs", f"make_{name}.txt"))
    log(f"sources {name} tex={tex} rc={rc} {sec:.1f}s")
    return d


# ------------------------------------------------------------------ e3 後片付け

def e3(B, env, src_dirs):
    rows = []
    for src_name, src in src_dirs:
        for cl in ("none", "objects", "purge", "reset"):
            for nf in ("object", "source"):
                tag = f"{src_name}_{cl}_{nf}"
                o = os.path.join(OUT, "e3", tag)
                shutil.rmtree(o, ignore_errors=True)
                cmd = [B, "-b", "--factory-startup", "--python-exit-code", "1", "--python", "convert.py", "--",
                       "--src", src, "--cleanup", cl, "--name-from", nf, "--out", o, "--tag", tag]
                rc, sec, _ = run(cmd, env=env, timeout=3600, logfile=os.path.join(OUT, "logs", f"e3_{tag}.txt"))
                lg = list(csv.DictReader(open(os.path.join(o, "log.csv"), encoding="utf-8")))
                n_out = len([x for x in os.listdir(os.path.join(o, "items")) if x.endswith(".glb")])
                ok = sum(int(r["ok"]) for r in lg)
                rss0, rss1 = float(lg[0]["rss_mb"]), float(lg[-1]["rss_mb"])
                rss_max = max(float(r["rss_mb"]) for r in lg)
                rows.append([src_name, cl, nf, rc, round(sec, 2), ok, n_out,
                             sum(int(r["overwrote"] or 0) for r in lg), rss0, rss1, rss_max,
                             lg[-1]["n_meshes"], lg[-1]["n_images"], lg[1]["obj_name"], lg[-1]["obj_name"]])
                log(f"e3 {tag} rc={rc} ok={ok} out={n_out} rss {rss0}->{rss1} {sec:.1f}s")
    write_csv(os.path.join(OUT, "e3_summary.csv"),
              ["src", "cleanup", "name_from", "exit", "sec_wall", "ok", "out_glb", "overwrote",
               "rss_first", "rss_last", "rss_max", "meshes_left", "images_left", "name_2nd", "name_last"], rows)


# ------------------------------------------------------------------ e4 回し方

def e4(B, env, src, engines, parallels, n):
    rows = []

    def conv(tag, start, count, engine, o):
        return [B, "-b", "--factory-startup", "--python-exit-code", "1", "--python", "convert.py", "--",
                "--src", src, "--n", str(count), "--start", str(start), "--cleanup", "purge",
                "--name-from", "source", "--render", engine, "--res", "256", "--samples", "16",
                "--out", o, "--tag", tag]

    for engine in engines:
        # ★ウォームアップ(p976の教訓:そのマシンで最初にシェーダを要求した処理だけ15秒余計にかかる)
        o = os.path.join(OUT, "e4", f"warmup_{engine}")
        shutil.rmtree(o, ignore_errors=True)
        rc, sec, _ = run(conv("warmup", 0, 1, engine, o), env=env,
                         logfile=os.path.join(OUT, "logs", f"e4_warmup_{engine}.txt"))
        rows.append([engine, "warmup", 1, 1, rc, round(sec, 2), ""])
        log(f"e4 {engine} warmup rc={rc} {sec:.1f}s")

        # (a) 1プロセスで n 個
        o = os.path.join(OUT, "e4", f"{engine}_single")
        shutil.rmtree(o, ignore_errors=True)
        rc, sec, _ = run(conv("single", 0, n, engine, o), env=env,
                         logfile=os.path.join(OUT, "logs", f"e4_{engine}_single.txt"))
        rows.append([engine, "single", 1, n, rc, round(sec, 2), count_png(o)])
        log(f"e4 {engine} single rc={rc} {sec:.1f}s")

        # (b) 1個ずつ起動し直す
        o = os.path.join(OUT, "e4", f"{engine}_per_item")
        shutil.rmtree(o, ignore_errors=True)
        t0 = time.perf_counter()
        bad = 0
        for i in range(n):
            rc, _, _ = run(conv("per_item", i, 1, engine, o), env=env,
                           logfile=os.path.join(OUT, "logs", f"e4_{engine}_per_item_{i:03d}.txt"))
            bad += int(rc != 0)
        sec = time.perf_counter() - t0
        rows.append([engine, "per_item", n, n, f"fails={bad}", round(sec, 2), count_png(o)])
        log(f"e4 {engine} per_item fails={bad} {sec:.1f}s")

        # (c) 並列 k 本(n を k 等分)
        for k in parallels:
            o = os.path.join(OUT, "e4", f"{engine}_par{k}")
            shutil.rmtree(o, ignore_errors=True)
            os.makedirs(o, exist_ok=True)
            per = (n + k - 1) // k
            t0 = time.perf_counter()
            procs = []
            for j in range(k):
                start = j * per
                cnt = min(per, n - start)
                if cnt <= 0:
                    continue
                lf = open(os.path.join(OUT, "logs", f"e4_{engine}_par{k}_{j}.txt"), "wb")
                procs.append((subprocess.Popen(conv(f"par{k}", start, cnt, engine, o), cwd=HERE, env=env,
                                               stdout=lf, stderr=subprocess.STDOUT), lf))
            codes = []
            for p, lf in procs:
                codes.append(p.wait())
                lf.close()
            sec = time.perf_counter() - t0
            rows.append([engine, f"par{k}", k, n, "/".join(map(str, codes)), round(sec, 2), count_png(o)])
            log(f"e4 {engine} par{k} codes={codes} {sec:.1f}s")
    write_csv(os.path.join(OUT, "e4_strategy.csv"),
              ["engine", "strategy", "processes", "items", "exit", "sec_wall", "png_written"], rows)


def count_png(o):
    d = os.path.join(o, "items")
    return len([x for x in os.listdir(d) if x.endswith(".png")]) if os.path.isdir(d) else 0


# ------------------------------------------------------------------ e5 画面なしで動かない操作

def e5(B, env, gui):
    run([B, "-b", "--factory-startup", "--python", "probe_ops.py", "--", "--out",
         os.path.join(OUT, "e5_probe_background.csv")], env=env, timeout=600,
        logfile=os.path.join(OUT, "logs", "e5_background.txt"))
    log("e5 background done")
    if gui:
        # ★画面が一瞬開いて閉じる(2回)
        run([B, "--factory-startup", "--python", "probe_ops.py", "--", "--out",
             os.path.join(OUT, "e5_probe_gui_immediate.csv"), "--quit"], env=env, timeout=300,
            logfile=os.path.join(OUT, "logs", "e5_gui_immediate.txt"))
        run([B, "--factory-startup", "--python", "probe_ops.py", "--", "--out",
             os.path.join(OUT, "e5_probe_gui_defer.csv"), "--defer", "--quit"], env=env, timeout=300,
            logfile=os.path.join(OUT, "logs", "e5_gui_defer.txt"))
        log("e5 gui done")


# ------------------------------------------------------------------ e6 パス

def e6(B, env):
    rows = []
    base = os.path.join(OUT, "e6")
    shutil.rmtree(base, ignore_errors=True)
    os.makedirs(base, exist_ok=True)

    # (1) 保存していないシーンで // を使うと、どこに書かれるか(カレントディレクトリを変えて2回)
    expr = ("import bpy,os;sc=bpy.context.scene;sc.render.engine='BLENDER_WORKBENCH';"
            "sc.render.resolution_x=sc.render.resolution_y=32;sc.render.filepath='//unsaved_out.png';"
            "print('CWD',os.getcwd());print('ABS',bpy.path.abspath(sc.render.filepath));"
            "bpy.ops.render.render(write_still=True)")
    for label, cwd in (("cwd_here", HERE), ("cwd_base", base)):
        rc, sec, txt = run([B, "-b", "--factory-startup", "--python-expr", expr], cwd=cwd, env=env, timeout=300,
                           logfile=os.path.join(OUT, "logs", f"e6_unsaved_{label}.txt"))
        ab = next((ln[4:] for ln in txt.splitlines() if ln.startswith("ABS ")), "")
        err = next((ln.strip() for ln in txt.splitlines() if "cannot save" in ln), "")
        rows.append(["unsaved_//", label, rc, f"abspath={ab} / {err}",
                     os.path.exists(os.path.join(cwd, "unsaved_out.png"))])
        log(f"e6 unsaved // {label} -> {ab}")

    # (2) .blend を保存してから -o //frames/f_#### -f 1
    blend = os.path.join(base, "scene.blend")
    run([B, "-b", "--factory-startup", "--python-expr",
         f"import bpy;sc=bpy.context.scene;sc.render.engine='BLENDER_WORKBENCH';"
         f"sc.render.resolution_x=sc.render.resolution_y=32;bpy.ops.wm.save_as_mainfile(filepath=r'{blend}')"],
        env=env, timeout=300)
    rc, sec, txt = run([B, "-b", blend, "-o", "//frames/f_####", "-F", "PNG", "-f", "1"], cwd=HERE, env=env,
                       timeout=300, logfile=os.path.join(OUT, "logs", "e6_saved_o.txt"))
    rows.append(["saved_-o_//", "", rc, os.path.join(base, "frames", "f_0001.png"),
                 os.path.exists(os.path.join(base, "frames", "f_0001.png"))])
    # ★引数の順番: -o を -f の後ろに書くと効かない(引数は左から順に実行される)
    rc, sec, txt = run([B, "-b", blend, "-f", "1", "-o", "//late/f_####"], cwd=HERE, env=env,
                       timeout=300, logfile=os.path.join(OUT, "logs", "e6_order.txt"))
    written = [ln for ln in txt.splitlines() if "Saved:" in ln]
    rows.append(["-f_before_-o", "", rc, written[0].strip() if written else "",
                 os.path.exists(os.path.join(base, "late", "f_0001.png"))])
    log(f"e6 -f before -o -> {written[:1]}")

    # (3) 日本語を含むフォルダで変換を回す
    jp = os.path.join(base, "作業フォルダ_日本語")
    src = os.path.join(OUT, "src")
    if os.path.isdir(src):
        jsrc = os.path.join(jp, "元データ")
        shutil.copytree(src, jsrc)
        o = os.path.join(jp, "出力")
        rc, sec, txt = run([B, "-b", "--factory-startup", "--python-exit-code", "1", "--python", "convert.py", "--",
                            "--src", jsrc, "--n", "10", "--cleanup", "purge", "--name-from", "source",
                            "--out", o, "--tag", "jp"], env=env, timeout=1800,
                           logfile=os.path.join(OUT, "logs", "e6_japanese.txt"))
        n = len([x for x in os.listdir(os.path.join(o, "items"))]) if os.path.isdir(os.path.join(o, "items")) else 0
        rows.append(["japanese_dir", "", rc, o, n])
        log(f"e6 japanese dir rc={rc} files={n}")
    write_csv(os.path.join(OUT, "e6_paths.csv"), ["case", "variant", "exit", "path", "result"], rows)


# ------------------------------------------------------------------ main

def main():
    ap = argparse.ArgumentParser()
    ap.add_argument("--blender", required=True)
    ap.add_argument("--only", default="all")
    ap.add_argument("--quick", action="store_true", help="Macでの動作確認用(回数・個数を減らす)")
    ap.add_argument("--no-gui", action="store_true")
    a = ap.parse_args()
    B = a.blender
    if not os.path.exists(B):
        log(f"[STOP] blender not found: {B}")
        sys.exit(2)
    only = set("e0,e1,e2,e3,e4,e5,e6".split(",")) if a.only == "all" else set(a.only.split(","))
    os.makedirs(os.path.join(OUT, "logs"), exist_ok=True)
    iso = os.path.join(HERE, "blender_home")
    env_iso = user_env(iso)
    env_user = user_env(None)

    if "e0" in only:
        e0(B, env_iso)
    if "e1" in only:
        e1(B, env_iso, env_user, reps=2 if a.quick else 5)
    src = make_src(B, env_iso, 512, "src")
    if "e2" in only:
        e2(B, env_iso)
    if "e3" in only:
        srcs = [("tex512", src)]
        if not a.quick:
            srcs.append(("tex2048", make_src(B, env_iso, 2048, "src2k")))
        e3(B, env_iso, srcs)
    if "e4" in only:
        if a.quick:
            e4(B, env_iso, src, ["workbench"], [2], 6)
        else:
            e4(B, env_iso, src, ["eevee", "cycles"], [2, 4], 100)
    if "e5" in only:
        e5(B, env_iso, gui=not a.no_gui)
    if "e6" in only:
        e6(B, env_iso)
    log("ALL DONE")


if __name__ == "__main__":
    main()
参考サイト
- Command Line Arguments(Blender Manual)(
-b・--python-exit-code・--factory-startupの説明と、引数を書く順番の例) - BlendData(Blender Python API)(
orphans_purgeの引数do_recursive) - Context(Blender Python API)(
temp_overrideで操作の前提を差し替える方法) - Application Timers(Blender Python API)(
bpy.app.timers.registerで処理を後ろにずらす方法) - Using Operators(Blender Python API の Gotchas)(オペレーターが画面の状態に左右される理由)
それでは、今回はここまで。最後までありがとうございました😊