この記事について
6月に Stable DiffusionをMacで動かしてみた と ComfyUIで画像生成ワークフローを組んでみた を書きました。あれから3か月で、Macの画像生成はずいぶん様子が変わっています。主役のモデルは Stable Diffusion から FLUX などの新しい世代に移り、道具も「Draw Things」というMacのアプリが勧められることが多くなりました。eightのMacも macOS 27 に上がっています。
そこでこの記事では、2026年9月の時点で、Macで画像生成AIを無料で始めるなら何を使えばいいのかを、実際に動かして確かめました。6月の手順がまだ動くのか、道具ごとに速さはどう違うのか、モデルの世代でどれだけ絵が変わるのか、を順に見ていきます。
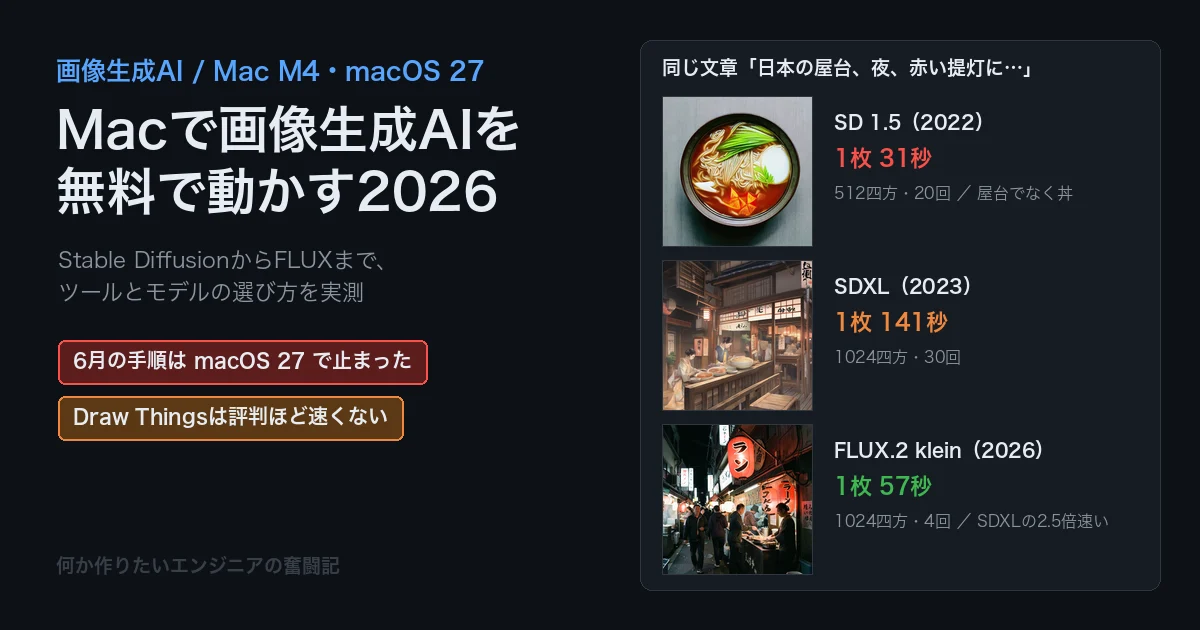
先に結論(Mac M4・メモリ32GB・macOS 27.0)
① 6月の手順は、macOS 27ではそのままでは動かなかった。原因はモデルの置き場所ではなく、Pythonの計算ライブラリ scipy。上げれば動く
② 同じ FLUX.2 [klein] 4B を3つの道具で動かすと、1枚 diffusers 約57秒・Draw Things 約62秒。mfluxは「キャッシュ上限」の設定を付けると、読み込みを含めて最も早く描き終わった(付けないと2枚目以降が遅くなる)。「Draw Thingsは20〜40%速い」という評判は、この条件では当たらなかった
③ 新しいFLUX.2 kleinは、古いSDXLより2.5倍速い(4ステップで描ける作りのため)。英語の看板もほぼ書けるが、頼んだ提灯に「ラーメン」と正しく書けた道具は無かった
④ 6月に書いた「MacではFloat32が安定」は、もう要らない。Float16でも真っ黒な画像は0枚
⑤ ⚠Draw ThingsのAPIサーバーは、有効にすると同じネットワークのほかの機器からも使える設定で立ち上がる。自分のパソコンだけに絞っても、アプリを開き直すと元に戻った
この記事には、下調べが1つと、実験が4つあります。使ったのは、App Storeの無料アプリ Draw Things、Apple向けのコマンド mflux、Pythonのライブラリ diffusers、それから ComfyUI の4つです。
用語集
画像生成の言葉、モデルの言葉、道具の言葉、の順に並べています。
| 言葉 | 何を指すのか |
|---|---|
| 画像生成AI(拡散モデル) | 文章から絵を描くAI。ノイズだらけの画像から、少しずつノイズを取り除いて絵に仕上げていく作り(拡散モデル)が主流 |
| プロンプト | 「どんな絵を描いてほしいか」を書いた文章 |
| ステップ数 | ノイズを取り除く回数。多いほど丁寧だが時間がかかる。古いモデルは20〜30回、新しいモデルは4回で描けるものがある |
| 種(シード) | 最初のノイズを決める数字。同じモデル・同じ設定・同じ種なら、同じ絵になる(はずのもの。道具が違うと絵は変わる。実験2で確認) |
| ガイダンス | プロンプトにどれだけ忠実に描かせるかの強さ。FLUX.2 kleinは1.0が標準 |
| サンプラー | ノイズの取り除き方の手順。同じモデルでも、サンプラーが違うと絵が変わる |
| テキストエンコーダ | プロンプトの文章を、モデルが読める数字に変える部品。FLUX.2 kleinでは本体と同じくらい大きい(約8GB) |
| Float32/Float16/BF16 | 数値を何ビットで持つか。Float32は正確だが重く、Float16・BF16は半分の大きさで速い。6月は「MacではFloat32でないと画像が真っ黒になる」と書いていた(実験4で確認) |
| 量子化 | 数値をさらに少ないビット(8ビット・4ビットなど)に丸めて、モデルを小さくすること。詳しくは p965 |
| 蒸留(ディスティレーション) | 大きなモデルの振る舞いをまねるように、小さく・少ないステップで描けるモデルを作ること。FLUX.2 kleinは蒸留されていて、4ステップで描ける |
| MPS/MLX | MacのGPUで計算するための仕組み。MPSはPyTorch(diffusers・ComfyUI)が使う入口、MLXはAppleが作った機械学習の部品(mfluxが使う) |
| Hugging Face | AIのモデルが公開されているサイト。モデルによっては、ダウンロードの前にログインと利用条件への同意が要る(この記事では、ログインが要るモデルは使っていない) |
| API(APIサーバー) | ほかのプログラムから機能を呼び出すための入口。Draw Thingsは、有効にするとほかのプログラムやほかの機器から画像生成を頼めるようになる |
【下調べ】2026年秋の道具とモデル
まず、いまMacで無料で使える道具と、ログインなしで取れるモデルを整理しました。
| 道具 | どんなものか | 向いている人 | 今回の版 |
|---|---|---|---|
| Draw Things | App Storeの無料アプリ。モデルのダウンロードから生成まで画面だけでできる | まず試したい人 | 26.0924.0 |
| mflux | AppleのMLXで動くコマンド。FLUX系のモデルに強い | コマンドで何枚も回したい人 | 0.20.0 |
| diffusers | Hugging FaceのPythonライブラリ。自分のプログラムに組み込める | アプリに組み込みたい人(p914で使用) | 0.40.0 |
| ComfyUI | 部品を線でつないで手順を組むアプリ。Mac用のアプリ版(Comfy Desktop)もある | 手順を細かく作り込みたい人(p918で使用) | 0.37.0 |
同じ「FLUX.2 [klein] 4B」でも、道具ごとに計算の土台とモデルのファイルが違います。そのため、同じ種を指定しても同じ絵にはならず、速さも変わります(実験2)。Draw Thingsのモデルは、ほかの道具と共有できない点も覚えておくとよいです。
モデルは、ログインや同意なしでダウンロードできて、利用条件のゆるいものだけを選びました。Hugging Faceの情報(2026-09-29時点)で確かめた結果です。
| モデル | 公開 | ライセンス | ログイン | 今回 |
|---|---|---|---|---|
| Stable Diffusion 1.5 | 2022 | CreativeML Open RAIL-M | 不要 | ○ |
| Stable Diffusion XL(SDXL) | 2023 | CreativeML Open RAIL++-M | 不要 | ○ |
| FLUX.2 [klein] 4B | 2026 | Apache 2.0 | 不要 | ○(主役) |
| FLUX.1 [schnell] | 2024 | Apache 2.0 | 要る | × |
| FLUX.1 [dev]・SD 3.5 | 2024 | 独自(FLUX.1 devは非商用) | 要る | × |
| Z-Image-Turbo・Qwen-Image | 2025 | Apache 2.0 | 不要 | ×(大きすぎる。本体だけで20GB以上) |
FLUX.1 [schnell] はライセンスこそApache 2.0ですが、ダウンロードの前にログインと同意が要る設定になっていました。ライセンスがゆるいことと、すぐ取れることは別です。また、同じFLUX.2 [klein]でも、9B(90億)版は非商用のライセンスで、4B版だけがApache 2.0です(モデルの説明ページに明記)。
生成した画像の扱い(ライセンスの原文から、事実だけ)
SD 1.5とSDXLのライセンスには「生成物の権利は主張しない。ただし生成物とその使い方の責任は使う人にあり、ライセンスの制限に反する使い方はできない」という趣旨の条項があり、別紙で違法な用途などを禁止しています。FLUX.2 [klein] 4BはApache 2.0で、モデルの説明ページでは違法な内容の生成などを禁じる方針が示されています。どのモデルでも、実在の人物や他人の作品に似せた画像を作れば、ライセンスとは別に法律の問題になり得る点は変わりません。
ちなみに、Ollamaの使い方2026 で使ったOllamaにも試験的な画像生成の機能がありましたが、0.32.6(2026-08-04)で「一時的に外す」とされ、最新の0.35.0(2026-09-28)までのリリースノートに、戻したという記載はありません。Macで画像生成をするなら、今回の4つのどれかを使うことになります。
【実験1・Mac】6月の手順は、macOS 27でも動くのか
最初に、6月の記事の手順がいまも使えるかを確かめました。
モデルの置き場所:取り下げられた旧URLは、転送されるようになっていた
6月の時点では、SD 1.5 は runwayml/stable-diffusion-v1-5 という場所から取るのが定番でした。この場所は後に取り下げられ、8月に確かめたときは取得できませんでした(HTTP 401)。今回あらためて旧URLにアクセスすると、次のように新しい置き場所へ自動で転送(307)されました。
$ curl -sI https://huggingface.co/runwayml/stable-diffusion-v1-5/resolve/main/v1-5-pruned-emaonly.safetensors
HTTP/2 307
location: /stable-diffusion-v1-5/stable-diffusion-v1-5/resolve/main/v1-5-pruned-emaonly.safetensors
いまの正しい置き場所は stable-diffusion-v1-5/stable-diffusion-v1-5 です(p914・p918は8月に書き換え済み)。古い記事のURLのままでも取れますが、転送がいつまで続くかは分からないので、新しい名前で書いておくのが安全です。
6月のスクリプトとComfyUIを、そのまま動かす
p914のスクリプト(diffusersでSD 1.5を使う)と、6月に入れたComfyUI 0.24.0 を、何も変えずに動かしました。結果はどちらも動きました(p914のスクリプトは20ステップで約26秒、ComfyUIは1枚27.8秒)。
ただし、これには条件がありました。eightは検証の2日前(9/27)に、別の件で scipy(Pythonの計算ライブラリ)を 1.15.2 から 1.17.1 に上げていました。そこで、古い 1.15.2 を一時的に使う形で同じことをすると、diffusersもComfyUIも、読み込みの段階で止まりました。
ImportError: dlopen(.../scipy/sparse/linalg/_propack/_spropack.cpython-312-darwin.so, 0x0002):
  ... (section '__DATA/__thread_bss' has a zero-fill section type, but offset field is not zero)
macOS 27 は、古い作り方をされたライブラリのファイルを読み込まなくなっていて、scipy 1.15.2 の一部のファイルがそれに当たります。diffusers も ComfyUI も、中で scipy を使っているので巻き添えになります。macOS 27 に上げたあとで6月の手順が動かないときは、まず scipy を上げてください。
python3 -m pip install "scipy==1.17.1" "numpy==1.26.4"numpy を 1.26.4 のまま指定しているのは、最新の scipy 1.18 は numpy 2 以上を求め、ほかのツールに影響が広がるためです。
【準備・Mac】Draw Thingsを入れて、モデルを選ぶ
Draw Things は App Store から無料で入れられます(Apple IDでの入手はeightが行いました)。初めて開くと、モデルをどこから手に入れるかを聞かれます。
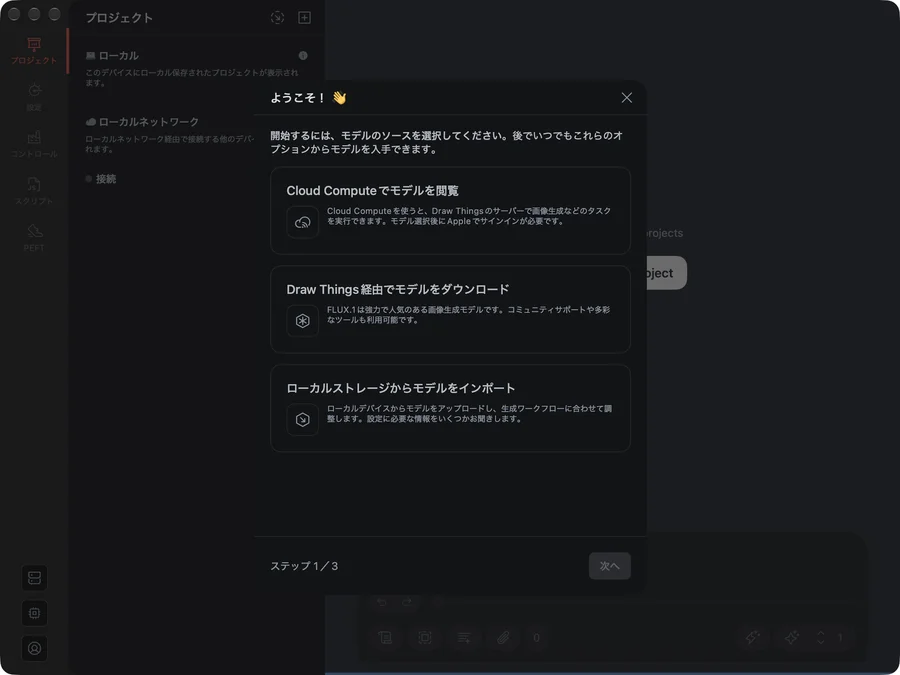
- Cloud Computeでモデルを閲覧 … Draw Thingsのサーバーで生成する。Appleでのサインインが要る。手元では計算しない
- Draw Things経由でモデルをダウンロード … モデルを手元に落として、自分のMacで生成する。今回はこれ
- ローカルストレージからモデルをインポート … 自分で取ってきたモデルのファイルを読み込ませる
次の画面で使うモデルを選びます。一覧の上の検索欄に「klein」と入れると、FLUX.2 [klein] の版が並びます。
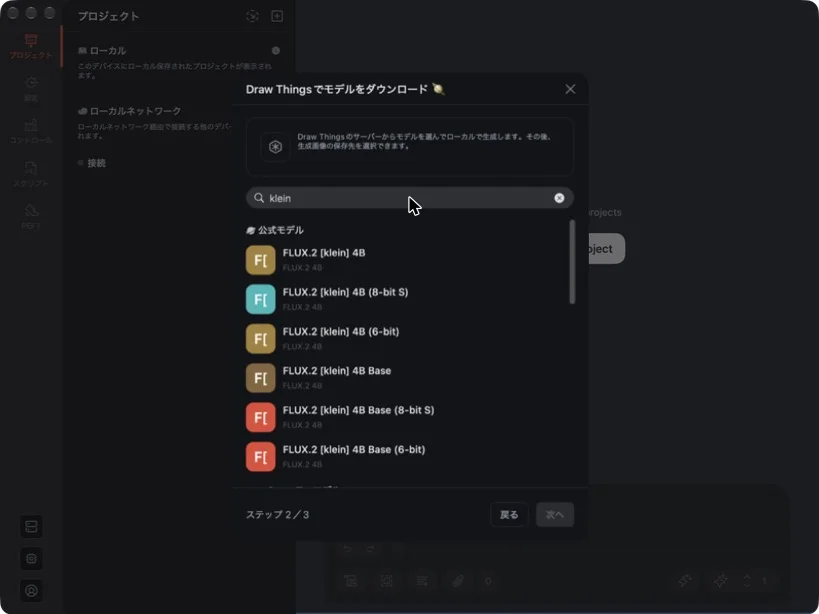
無印・8-bit S・6-bit と、「Base」の付く版があります。ほかの道具と条件をそろえるため、圧縮していない無印の「FLUX.2 [klein] 4B」を選びました。「次へ」を押すと、ネットワーク経由でダウンロードしてよいかの確認のあと、ダウンロードが始まります。
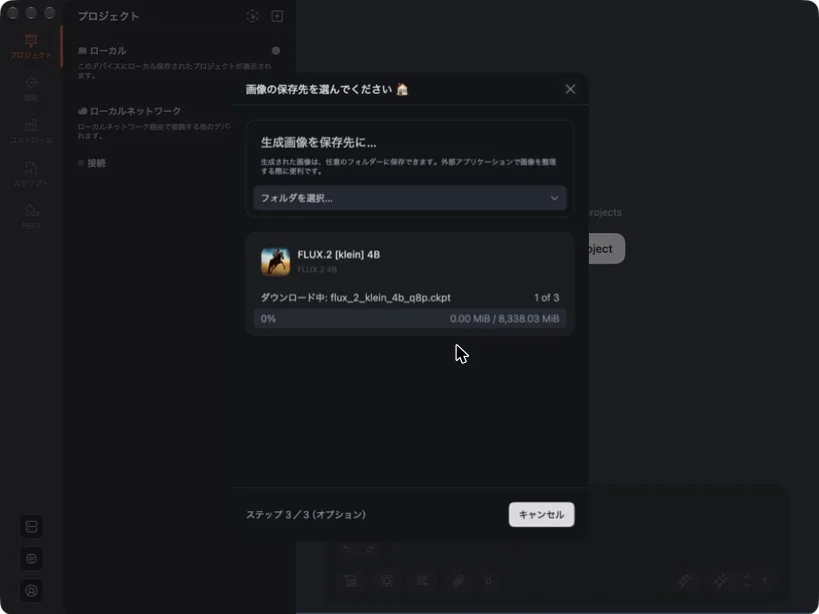
取ってくるファイルは3つで、1つ目は flux_2_klein_4b_q8p.ckpt(8,338MB)でした。名前に「q8」と入っていますが、40億個の数値を16ビットで持つのと同じくらいの大きさです。Draw Things独自の形式で、中身の詳しい作りは公開情報からは確かめられませんでした。
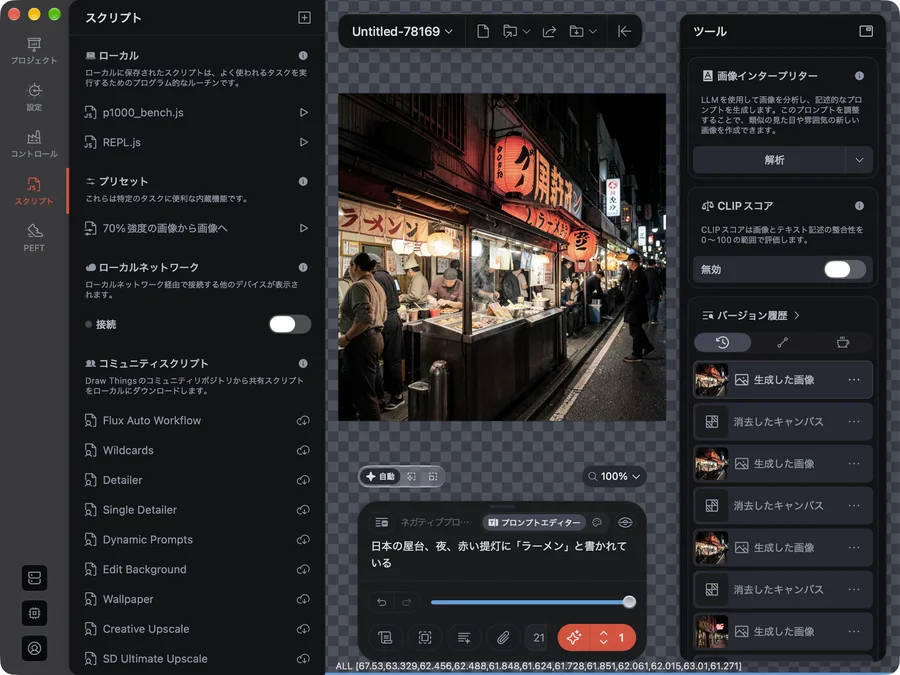
ダウンロードが終わると、画面下の入力欄にプロンプトを書いて、右下の生成ボタンを押せば描き始めます。左の「設定」でモデル・画像の大きさ・ステップ数・種などを変えられます。
【準備・Mac】diffusers・mflux・ComfyUIを入れる
残りの3つは、ターミナルから入れます。普段のPythonの環境を汚さないよう、作業用のフォルダに専用の環境(仮想環境)を作りました。Pythonは3.12.5 を使っています(3.10以上が必要)。
mkdir imagegen && cd imagegen
python3 -m venv .venv
.venv/bin/pip install "torch==2.14.0" "diffusers==0.40.0" "transformers==5.17.0" \
    "accelerate==1.15.0" "mflux==0.20.0" safetensors sentencepiece
mflux は、入れるとすぐにコマンドで使えます。FLUX.2 [klein] 4B なら次の1行です(初回はモデル約16GBを自動でダウンロードします。diffusersと同じ置き場所を使うので、どちらかで一度取れば済みます)。
.venv/bin/mflux-generate-flux2 --model flux2-klein-4b \
    --prompt "a beautiful sunset over mountains, photorealistic, golden hour" \
    --width 1024 --height 1024 --steps 4 --guidance 1.0 --seed 42 \
    --mlx-cache-limit-gb 2 --output sunset.png
100%|██████████| 4/4 [00:49<00:00, 12.35s/it]
Peak MLX memory: 17.95 GB
real 56.56最後の --mlx-cache-limit-gb 2 は、実験2で分かった大事な設定です(後述)。この1枚は、モデルの読み込みを含めて56.6秒でした。
diffusers は、Pythonのスクリプトから使います。最小の形は次のとおりです(実験に使った計測用の全文は付録)。
import torch
from diffusers import Flux2KleinPipeline

pipe = Flux2KleinPipeline.from_pretrained(
    "black-forest-labs/FLUX.2-klein-4B", torch_dtype=torch.bfloat16).to("mps")
image = pipe(prompt="a beautiful sunset over mountains, photorealistic, golden hour",
             width=1024, height=1024, num_inference_steps=4, guidance_scale=1.0,
             generator=torch.Generator("cpu").manual_seed(42)).images[0]
image.save("sunset.png")
ComfyUI は、GitHubから取ってきて同じ環境に入れます(Mac用のアプリ版「Comfy Desktop」もあります)。
git clone --depth 1 --branch v0.37.0 https://github.com/comfyanonymous/ComfyUI.git
cd ComfyUI
../.venv/bin/pip install -r requirements.txt
../.venv/bin/python main.py # → ブラウザで http://127.0.0.1:8188 を開くComfyUIは、何も指定しなければ自分のパソコンの中(127.0.0.1)だけで待ち受けます(lsof で確認)。この点は、あとで出てくるDraw Thingsと対照的です。
【実験2・Mac】同じモデルを3つの道具で描かせる
同じ FLUX.2 [klein] 4B を、Draw Things・diffusers・mflux で動かしました。条件は、1024×1024・4ステップ・ガイダンス1.0・種42。プロンプトは差が出やすい4つ(夕焼けの山/コーヒーを持つ手/英語の看板「OPEN」「MAC 2026」/日本語の提灯「ラーメン」)を、それぞれ3回ずつです。
Draw Thingsの時間は、アプリに組み込まれた「スクリプト」(JavaScript)で、生成の前後の時刻を記録して測りました(左の「スクリプト」→ 右上の「+」で新しいスクリプトを作り、▶で実行)。
| 道具 | 1回目(読み込み込み) | 2回目以降(1枚) | メモリ |
|---|---|---|---|
| Draw Things | 67.5秒 | 61.3〜63.3秒(平均 62.2秒) | (別アプリのため測れず) |
| diffusers(BF16) | 読み込み23.7秒+64.6秒 | 55.7〜58.8秒(平均 56.8秒) | GPU側 25.7GB |
| mflux(量子化なし) | 読み込み 約24秒 | 52〜78秒(同じ起動の中で2・3枚目が遅くなる) | ピーク 26.3GB |
※mfluxの時間は、mflux自身が表示する「描く部分」の時間です。ほかの2つはプロンプトを読む部分と画像を仕上げる部分も含むので、mfluxは数秒ぶん有利な数字です。
この表の中では diffusers がいちばん速く、Draw Thingsは約1割遅くなりました(mfluxは、次の節の設定を足すと逆転します)。ネットで見かける「Draw ThingsはComfyUIより20〜40%速い」は別の条件(別のモデルや機種)の話で、少なくともM4・32GBでFLUX.2 kleinの無印版を使うかぎりは当てはまりませんでした。
3つとも1枚に約1分かかるのは、メモリをほぼ使い切っているからです。FLUX.2 kleinは「4B」と小さく見えますが、プロンプトを読む部品(テキストエンコーダ)も約8GBあり、本体と合わせて16GB。そこに1024×1024の途中の計算が乗り、32GBのMacでもGPU側は25GB台まで埋まって、スワップ(ディスクへの退避)が3.7GB発生していました。
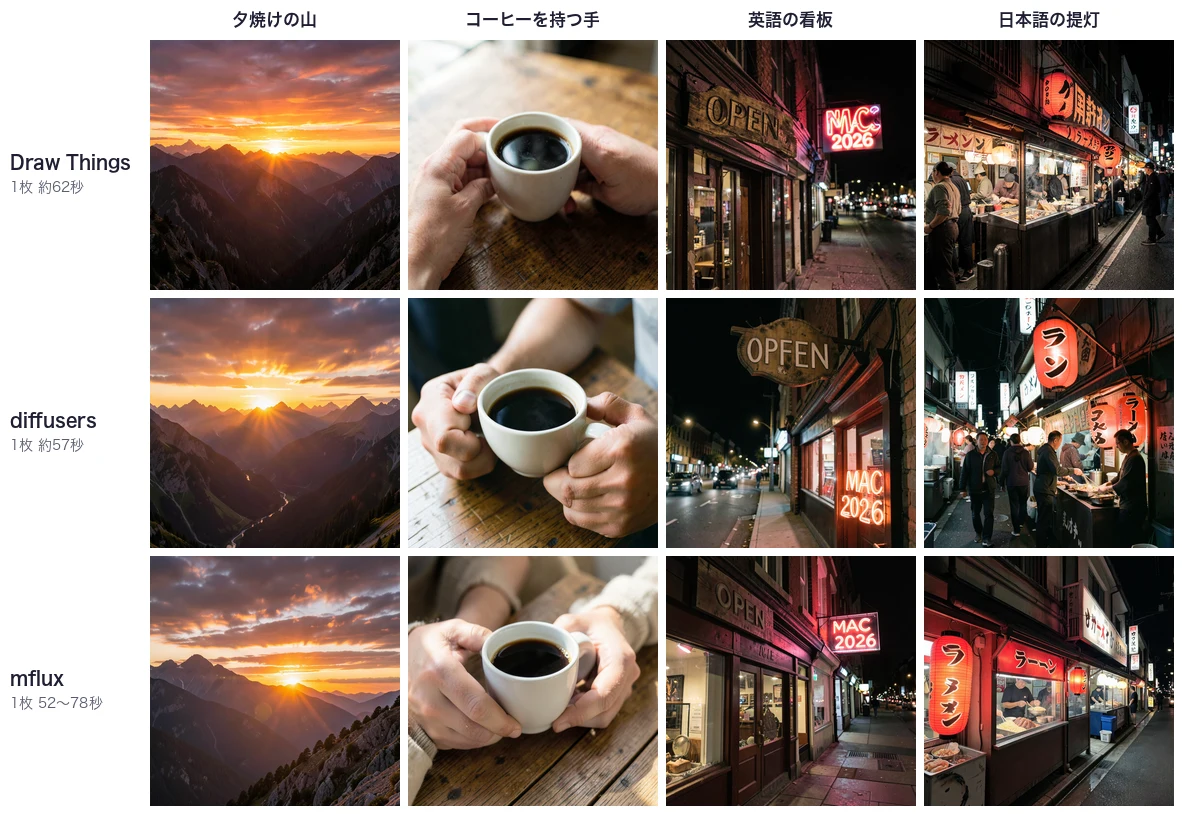
同じモデル・同じ種でも、道具が違うと絵は別物になりました。乱数の作り方や、サンプラー(Draw Thingsは既定でDDIM Trailing・シフト3.0)が違うためです。「種を同じにすれば同じ絵」は、同じ道具の中だけの話です。
文字を描かせた2枚の結果は次のとおりです。
| 英語の看板「OPEN」「MAC 2026」 | 日本語の提灯「ラーメン」 | |
|---|---|---|
| Draw Things | 「OPEN」は正しい・「MAC」は線が余計に絡んで崩れ気味 | 提灯は崩れる。ただしのれんに「ラーメン」と書けた |
| diffusers | 「OPFEN」と綴りを誤る・「MAC 2026」は正しい | 提灯は「ラン」「ラーン」 |
| mflux | 両方正しい | 提灯は崩れる・看板は「ラーーン」 |
英語はおおむね書けますが、頼んだとおり提灯に「ラーメン」と書けた道具はありませんでした。Draw Thingsはのれんに正しく書けたので、日本語の文字をまったく知らないわけではなく、狙った場所に狙った文字を書くのがまだ苦手、という結果です。
mfluxの2枚目が遅くなる理由と、量子化の効き目
mfluxは、同じ起動の中で描き続けると 54秒→61秒→78秒 のように遅くなりました。mfluxには、読み込むときにモデルを8ビット・4ビットに圧縮する機能(--quantize 8/4)があるので、これで速くなるかも試しました。
| mfluxの設定 | 1枚(描く部分) | メモリのピーク |
|---|---|---|
| 量子化なし | 52〜78秒 | 26.3GB |
8ビット(--quantize 8) | 55〜76秒 | 25.9GB |
4ビット(--quantize 4) | 55〜65秒 | 25.9GB |
量子化なし+--mlx-cache-limit-gb 2 | 50秒・2枚目も50秒 | MLX 24.2GB |
4ビット+--mlx-cache-limit-gb 2 | 54秒・2枚目も54秒 | MLX 19.7GB |
量子化しても、速さもメモリのピークもほとんど変わりませんでした(できた画像は違うので、量子化自体は効いています)。原因は MLXのキャッシュでした。MLXは、使い終わったメモリをすぐには返さず、次に使うために抱え込みます。それがメモリを埋めて、2枚目以降を遅くしていました。--mlx-cache-limit-gb 2(抱え込むのは2GBまで)を付けると、2枚目も遅くならず、1枚50秒で安定しました。
そのうえで比べると、4ビットはメモリを4.5GB減らすものの、速さはむしろ少し遅い(50秒→54秒)結果でした。1024×1024の画像生成は計算そのものが重いので、圧縮したデータを元に戻す手間のほうが上回ります。量子化は「メモリが足りないMacで動かすための手段」で、「速くする手段」ではありません。
キャッシュ上限を付けたmfluxを、ほかの2つと「起動してから2枚描き終わるまで」で比べると次のとおりです(どれも1枚目にモデルの読み込みを含む)。
| 道具 | 起動から2枚描き終わるまで | 内訳 |
|---|---|---|
mflux(--mlx-cache-limit-gb 2) | 113.4秒 | 描く部分 50秒×2・残り約13秒 |
| Draw Things | 130.9秒 | 1枚目 67.5秒+2枚目 63.3秒 |
| diffusers(BF16) | 147.0秒 | 読み込み 23.7秒+64.6秒+58.8秒 |
mfluxは、モデルの読み込みにかかる時間がほとんど目立たず、数枚だけ描くならいちばん早く終わりました。1枚だけの実行でも、読み込み込みで56.6秒です(【準備】の章)。なお、続けて描いたのは2枚までなので、何十枚も描く場合の差は確かめていません。
【実験3・Mac】モデルの世代で、絵はどれだけ変わるのか
同じ4つのプロンプトを、SD 1.5(2022年)・SDXL(2023年)・FLUX.2 [klein] 4B(2026年)で描かせました(どれもdiffusers・種42。ステップ数と大きさは各モデルの標準)。
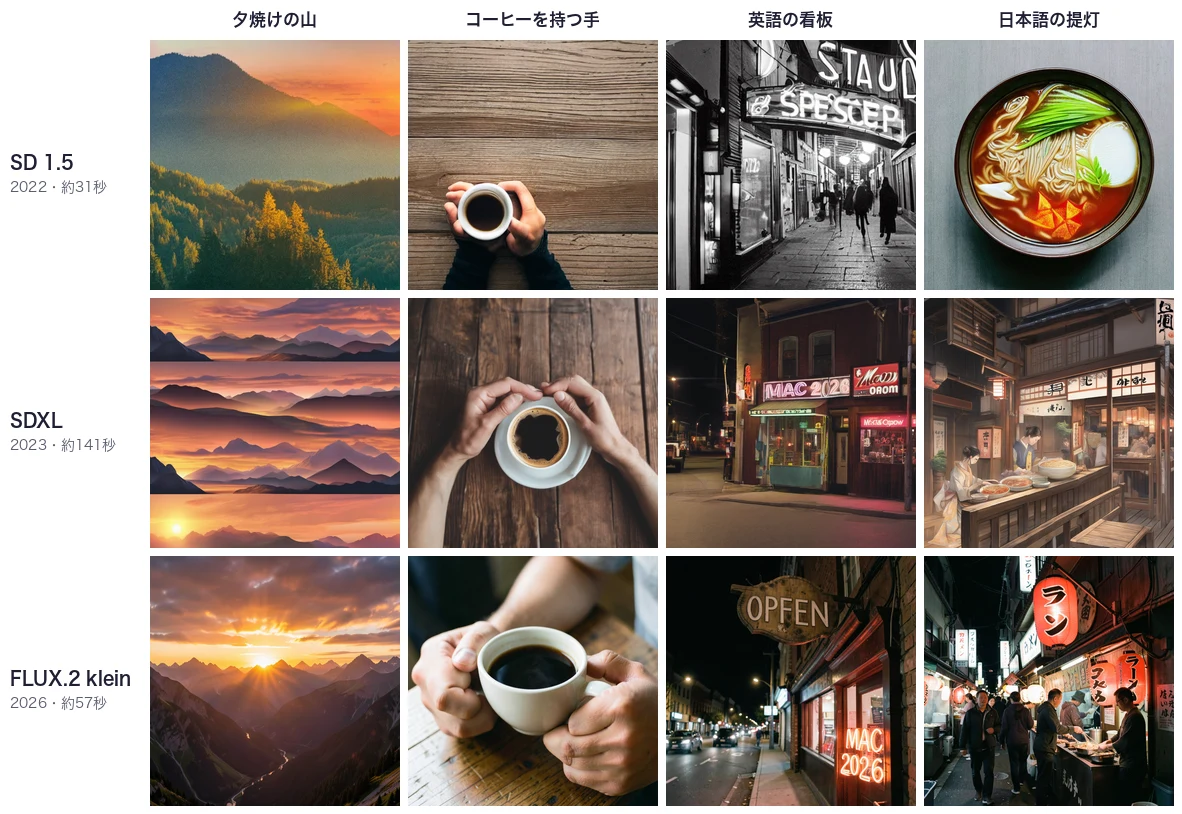
| モデル | 大きさ・ステップ | 1枚 | 英語の看板 | 日本語のプロンプト |
|---|---|---|---|---|
| SD 1.5 | 512×512・20 | 約31秒(Float32) | 「STAUD」「SPESCEP」=読めない | 屋台ではなく、ラーメンの丼を描いた |
| SDXL | 1024×1024・30 | 約141秒 | 「MAC 2026」は読める・「OPEN」が無い | 屋台の絵にはなるが、文字は読めない |
| FLUX.2 [klein] 4B | 1024×1024・4 | 約57秒 | ほぼ書ける(「OPFEN」の誤り) | 屋台の写真・提灯は「ラン」「ラーン」 |
見どころは3つです。
- 新しいモデルのほうが速い。FLUX.2 kleinはSDXLより2.5倍速く描けました。蒸留で4ステップで描ける作りになっているためで、「新しい=重い」とは限りません
- SD 1.5は日本語をほぼ理解しない。「日本の屋台、夜、赤い提灯に『ラーメン』と書かれている」から、夜の屋台ではなくラーメンの丼を描きました。プロンプトの中で読めたのが「ラーメン」くらいだったとみられます
- SDXLは、同じ種の夕焼けの山で、同じ山並みが帯のように何段も繰り返す崩れ方をしました。1回の結果なので断定はできませんが、古いモデルほど構図が崩れやすい傾向は見えます
【実験4・Mac】「MacではFloat32」は、今も必要か
6月のp914では、「MPSではFloat32が安定」と書いて、あえて重いFloat32で動かしていました。当時は、Float16にすると画像が真っ黒になることがあったためです。同じSD 1.5をFloat16でも描かせて、真っ黒な画像が出るか(画素の明るさの平均で判定)と、Float32との違いを見ました。
| Float32 | Float16 | |
|---|---|---|
| 1枚(512×512・20ステップ) | 30.7〜31.7秒 | 26.9〜27.9秒 |
| 真っ黒な画像 | 0/8 | 0/8 |
| Float32との画素の違い | — | 4枚中3枚は、10以上ずれた画素が0〜1.2%。看板の絵だけ13.5%(細部の描き方が変わる) |
Float16でも真っ黒な画像は1枚も出ず、絵もほぼ同じで、1割ほど速くなりました。6月の「Float32が安定」は、torch 2.14・diffusers 0.40 の組み合わせでは、もう気にしなくて大丈夫です。
おまけ:ComfyUIは6月から15%速くなっていた
6月のComfyUI 0.24.0と最新の0.37.0で、同じSD 1.5(512×512・20ステップ)を3回ずつ描かせました。
| ComfyUI | 1回目 | 2・3回目 |
|---|---|---|
| 0.24.0(6月・torch 2.12) | 25.8秒 | 22.3・23.2秒 |
| 0.37.0(最新・torch 2.14) | 23.4秒 | 19.7・19.2秒 |
約15%速くなっています。同じSD 1.5・20ステップのdiffusers(Float16で約27秒)よりも速い結果でした。なお、ComfyUIには、まったく同じ設定で2回目を頼むと、描き直さずに前の結果を使い回す仕組みがあります(エラーも出ません)。時間を測るときは、種を変えて頼む必要があります。
【つまずき・Mac】Draw ThingsのAPIサーバーは、家の中の誰からでも使える
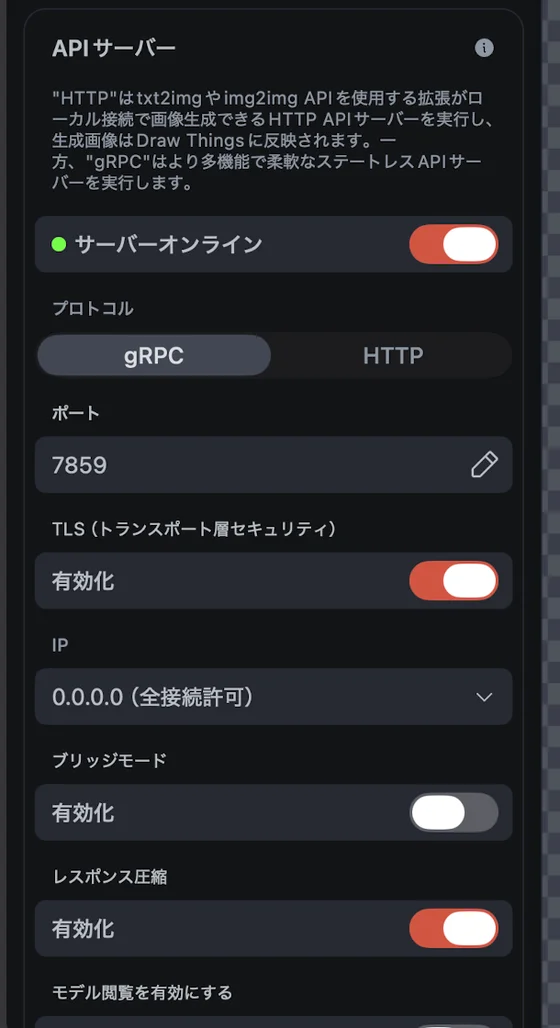
Draw Thingsには、ほかのプログラムから画像生成を頼める「APIサーバー」の機能があります(設定 → すべて → APIサーバー)。計測に使おうとして有効にしたところ、次の状態で立ち上がりました。
$ lsof -nP -iTCP -sTCP:LISTEN | grep DrawThing
DrawThing 30436 (ユーザー名) 51u IPv4 ... TCP *:7859 (LISTEN)IPの欄が「0.0.0.0(全接続許可)」で、実際に *:7859、つまり同じWi-Fiにつながったほかの機器からも受け付ける状態でした。家族のスマホや、カフェのWi-Fiの見知らぬ機器からも、このMacに画像を描かせられることになります。
IPの欄は「127.0.0.1(ローカルホストのみ)」に変えられ、変えると待ち受けも 127.0.0.1:7859 になりました。ところが、アプリを終了して開き直すと、IPは「0.0.0.0」に戻っていました。ほかに、プロトコルで「HTTP」を選んでも、実際にはgRPCのまま応答し、止めるとgRPCの表示に戻りました(HTTPのAPIは今回使えませんでした)。
Draw ThingsのAPIサーバーを使うときの注意
① 使わないなら有効にしない(既定はオフ)
② 使うときは、有効にするたびにIPの欄が「127.0.0.1」になっているか確かめる
③ ターミナルで lsof -nP -iTCP -sTCP:LISTEN | grep DrawThing と打ち、127.0.0.1:7859 なら自分のパソコンの中だけ、*:7859 ならネットワークに開いている
もう1つ、スクリプトの filesystem.pictures.path(画像の保存先)は、アプリ専用の場所に見えて、中身は普段の「ピクチャ」フォルダそのものでした。スクリプトで画像を保存すると、ピクチャフォルダに直接ファイルが増えます。
【ここから整理】どれを使えばいいか
| やりたいこと | おすすめ | 理由(今回の実測) |
|---|---|---|
| まず1枚描いてみたい | Draw Things | App Storeから入れて、画面だけでモデルの入手から生成までできる。速さはdiffusersの約1割遅い程度。APIサーバーは有効にしない |
| コマンドで何枚も回したい | mflux | 1行で動き、読み込みを含めると今回いちばん早く描き終わった。同じ種ならバイト単位で同じ画像が出る。--mlx-cache-limit-gb 2 を必ず付ける(付けないと2枚目以降が遅くなる) |
| 自分のアプリに組み込みたい | diffusers | 温まったあとの1枚はDraw Thingsより約1割速い。最初の読み込みに約24秒かかる。Float16で問題なし |
| 手順を細かく組みたい・SD系の資産を使いたい | ComfyUI | 最新版はSD 1.5で6月より15%速い。既定で自分のパソコンの中だけで待ち受ける |
モデルは、ログインなしで取れてApache 2.0の FLUX.2 [klein] 4B が第一候補です。SDXLより速く、英語の文字も書けます。ただし、メモリ32GBのMacでもほぼ使い切ります。今回、16GB以下のMacでは試していないので、それより少ないメモリで動くかは分かりません。mfluxの4ビット+キャッシュ上限でピークは約20GB、1枚だけなら18GBでした。
日本語の文字を画像の中に書かせたい場合は、今回の3世代のどれも、狙った場所には書けませんでした。文字は、あとから画像編集ソフトで入れるほうが確実です。
3か月で、モデルは速く・賢くなり、道具も増えました。一方で、OSの更新で古い手順が止まったり、設定が保存されなかったりと、「前に動いたから今も動く」とは限らないことも分かりました。久しぶりに動かすときは、まず1枚だけ描いて確かめるのがおすすめです。
実測した環境
Mac:Apple M4 / メモリ32GB / macOS 27.0
Draw Things 26.0924.0(App Store)/ mflux 0.20.0(MLX 0.32.3)/ diffusers 0.40.0・torch 2.14.0・transformers 5.17.0(Python 3.12.5)/ ComfyUI 0.37.0(比較用に6月の0.24.0・torch 2.12.0)/ scipy 1.17.1
モデル:black-forest-labs/FLUX.2-klein-4B(Apache 2.0)・stabilityai/stable-diffusion-xl-base-1.0・stable-diffusion-v1-5/stable-diffusion-v1-5。どの道具も執筆時点の最新版で、2026-09-29 に測りました。
【付録】スクリプト全文
実験に使ったスクリプトです。p1000_scripts.zip にまとめてあります。「【準備】」の章で作った .venv と同じフォルダに置いて実行してください。結果の画像と時間は out フォルダに保存されます。
.venv/bin/python bench_diffusers.py                 # 実験2:diffusers で FLUX.2 [klein] 4B
bash bench_mflux.sh                                 # 実験2:mflux(量子化なし)
bash bench_mflux.sh 4                               # 実験2:mflux(4ビット)
.venv/bin/python bench_generations.py sd15          # 実験3:SD 1.5(Float32)
.venv/bin/python bench_generations.py sdxl          # 実験3:SDXL
.venv/bin/python bench_generations.py sd15 --dtype fp16   # 実験4:SD 1.5(Float16)
python3 comfy_run.py --ckpt v1-5-pruned-emaonly.safetensors --out comfy.png   # ComfyUIを起動した状態で
dt_bench.js は Draw Things の中で使います(左の「スクリプト」→「+」で新しいスクリプトを作って貼り付け、▶で実行)。⚠画像は普段の「ピクチャ」フォルダに p1000_dt_p0.png〜p3.png として保存されます。
⚠bench_mflux.sh には、実験2で分かった --mlx-cache-limit-gb をあえて付けていません(付けない状態を測るため)。普段使うときは、「【準備】」の章の1行のように付けてください。
bench_diffusers.py … diffusers で FLUX.2 [klein] 4B(実験2)・58行
#!/usr/bin/env python3
"""diffusers で FLUX.2 [klein] 4B を動かし、読み込みと1枚あたりの時間を測る(Mac・MPS)。

  .venv/bin/python bench_diffusers.py --dtype bf16
"""
import argparse
import json
import os
import resource
import sys
import time

import torch
from diffusers import Flux2KleinPipeline

sys.stdout.reconfigure(line_buffering=True)
PROMPTS = [
    "a beautiful sunset over mountains, photorealistic, golden hour",
    "a close-up photo of hands holding a cup of coffee on a wooden table, natural light",
    'a street at night with a wooden shop sign that says "OPEN" and a neon sign that says "MAC 2026"',
    "日本の屋台、夜、赤い提灯に「ラーメン」と書かれている",
]


def main():
    ap = argparse.ArgumentParser()
    ap.add_argument("--dtype", choices=["bf16", "fp16", "fp32"], default="bf16")
    ap.add_argument("--runs", type=int, default=3)
    ap.add_argument("--out", default="out")
    a = ap.parse_args()
    dtype = {"bf16": torch.bfloat16, "fp16": torch.float16, "fp32": torch.float32}[a.dtype]

    t0 = time.perf_counter()
    pipe = Flux2KleinPipeline.from_pretrained("black-forest-labs/FLUX.2-klein-4B", torch_dtype=dtype).to("mps")
    load = time.perf_counter() - t0
    print(f"load {load:.1f}s  torch {torch.__version__}")
    res = {"tool": "diffusers", "dtype": a.dtype, "load_s": round(load, 2), "runs": []}
    for i, p in enumerate(PROMPTS):
        for r in range(a.runs):
            g = torch.Generator("cpu").manual_seed(42)
            t = time.perf_counter()
            img = pipe(prompt=p, width=1024, height=1024, num_inference_steps=4, guidance_scale=1.0,
                       generator=g).images[0]
            torch.mps.synchronize()
            sec = time.perf_counter() - t
            res["runs"].append({"prompt": i, "run": r, "sec": round(sec, 2)})
            print(f"prompt={i} run={r} {sec:.2f}s")
            if r == 0:
                img.save(f"{a.out}/diffusers_{a.dtype}_p{i}.png")
    res["peak_rss_gb"] = round(resource.getrusage(resource.RUSAGE_SELF).ru_maxrss / 1e9, 2)
    res["mps_driver_gb"] = round(torch.mps.driver_allocated_memory() / 1e9, 2)
    print(json.dumps(res))
    json.dump(res, open(f"{a.out}/bench_diffusers_{a.dtype}.json", "w"), indent=1)


if __name__ == "__main__":
    os.makedirs("out", exist_ok=True)
    main()
bench_mflux.sh … mflux で FLUX.2 [klein] 4B(実験2)・21行
#!/bin/bash
# mflux で FLUX.2 [klein] 4B を動かす。1回の起動で同じ種を3回描き、1枚目=冷えた状態・2〜3枚目=温まった状態。
# 使い方: bash bench_mflux.sh [量子化ビット数(省略で量子化なし)] ※ .venv と同じフォルダに置いて実行
cd "$(dirname "$0")" || exit 1
mkdir -p out
Q=${1:-}
TAG=${Q:+q$Q}; TAG=${TAG:-bf16}
QARG=${Q:+--quantize $Q}
P=(
  "a beautiful sunset over mountains, photorealistic, golden hour"
  "a close-up photo of hands holding a cup of coffee on a wooden table, natural light"
  'a street at night with a wooden shop sign that says "OPEN" and a neon sign that says "MAC 2026"'
  "日本の屋台、夜、赤い提灯に「ラーメン」と書かれている"
)
for i in 0 1 2 3; do
  echo "== prompt $i ($TAG)"
  /usr/bin/time -l .venv/bin/mflux-generate-flux2 --model flux2-klein-4b $QARG \
    --prompt "${P[$i]}" --width 1024 --height 1024 --steps 4 --guidance 1.0 \
    --seed 42 42 42 --output "out/mflux_${TAG}_p${i}_{seed}.png" 2>&1 \
    | tr '\r' '\n' | grep -E "100%|real|maximum resident|peak memory|Saved|Error|error" | tail -12
done
bench_generations.py … SD 1.5・SDXL(実験3・4)・71行
#!/usr/bin/env python3
"""モデルの世代で比べる(diffusers・Mac MPS)。同じ4つの文章を、SD 1.5 と SDXL で描く。
FLUX.2 [klein] 4B の結果は bench_diffusers.py のものを使う。

  .venv/bin/python bench_generations.py sd15
  .venv/bin/python bench_generations.py sdxl
  .venv/bin/python bench_generations.py sd15 --dtype fp16   # 実験4:6月の「float32が安定」は今も必要か
"""
import argparse
import json
import os
import sys
import time

import numpy as np
import torch
from diffusers import StableDiffusionPipeline, StableDiffusionXLPipeline

sys.stdout.reconfigure(line_buffering=True)
PROMPTS = [
    "a beautiful sunset over mountains, photorealistic, golden hour",
    "a close-up photo of hands holding a cup of coffee on a wooden table, natural light",
    'a street at night with a wooden shop sign that says "OPEN" and a neon sign that says "MAC 2026"',
    "日本の屋台、夜、赤い提灯に「ラーメン」と書かれている",
]
MODELS = {
    # 各モデルの標準的な使い方(公式の説明に合わせる)
    "sd15": dict(repo="stable-diffusion-v1-5/stable-diffusion-v1-5", cls=StableDiffusionPipeline, size=512, steps=20, cfg=7.5),
    "sdxl": dict(repo="stabilityai/stable-diffusion-xl-base-1.0", cls=StableDiffusionXLPipeline, size=1024, steps=30, cfg=7.0),
}


def main():
    ap = argparse.ArgumentParser()
    ap.add_argument("model", choices=MODELS)
    ap.add_argument("--dtype", choices=["fp32", "fp16"], default=None)
    ap.add_argument("--runs", type=int, default=2)
    a = ap.parse_args()
    m = MODELS[a.model]
    dtype_name = a.dtype or ("fp32" if a.model == "sd15" else "fp16")
    dtype = torch.float32 if dtype_name == "fp32" else torch.float16
    kw = dict(torch_dtype=dtype)
    if a.model == "sd15":
        kw["safety_checker"] = None
    if dtype == torch.float16 and a.model == "sdxl":
        kw.update(variant="fp16", use_safetensors=True)
    t0 = time.perf_counter()
    pipe = m["cls"].from_pretrained(m["repo"], **kw).to("mps")
    load = time.perf_counter() - t0
    print(f"{a.model} {dtype_name} load {load:.1f}s")
    res = {"model": a.model, "dtype": dtype_name, "load_s": round(load, 2), "size": m["size"], "steps": m["steps"], "runs": []}
    for i, p in enumerate(PROMPTS):
        for r in range(a.runs):
            g = torch.Generator("cpu").manual_seed(42)
            t = time.perf_counter()
            img = pipe(prompt=p, width=m["size"], height=m["size"], num_inference_steps=m["steps"],
                       guidance_scale=m["cfg"], generator=g).images[0]
            torch.mps.synchronize()
            sec = time.perf_counter() - t
            arr = np.asarray(img).astype(np.float32)
            black = float(arr.mean()) < 2.0          # 真っ黒(NaNで潰れた)かどうか
            res["runs"].append({"prompt": i, "run": r, "sec": round(sec, 2), "mean": round(float(arr.mean()), 1), "black": black})
            print(f"prompt={i} run={r} {sec:.2f}s mean={arr.mean():.1f}{' ★真っ黒' if black else ''}")
            if r == 0:
                img.save(f"out/gen_{a.model}_{dtype_name}_p{i}.png")
    json.dump(res, open(f"out/bench_gen_{a.model}_{dtype_name}.json", "w"), indent=1)


if __name__ == "__main__":
    os.makedirs("out", exist_ok=True)
    main()
comfy_run.py … ComfyUI に手順を送って時間を測る(実験1・ComfyUIの比較)・72行
#!/usr/bin/env python3
"""ComfyUI に「文章から画像を1枚」の手順(ワークフロー)を送り、描き終わるまでの時間を測る。標準ライブラリだけ。

  python3 comfy_run.py --port 8189 --ckpt v1-5-pruned-emaonly.safetensors --out exp1_comfy.png

手順はComfyUIの初期画面と同じ7つの部品:チェックポイント読込 → 文章×2 → 空の画像 → サンプラー → 画像に戻す → 保存。
"""
import argparse
import json
import sys
import time
import urllib.parse
import urllib.request

sys.stdout.reconfigure(encoding="utf-8", line_buffering=True)


def workflow(ckpt, prompt, negative, steps, cfg, seed, w, h, sampler="euler", scheduler="normal"):
    return {
        "1": {"class_type": "CheckpointLoaderSimple", "inputs": {"ckpt_name": ckpt}},
        "2": {"class_type": "CLIPTextEncode", "inputs": {"text": prompt, "clip": ["1", 1]}},
        "3": {"class_type": "CLIPTextEncode", "inputs": {"text": negative, "clip": ["1", 1]}},
        "4": {"class_type": "EmptyLatentImage", "inputs": {"width": w, "height": h, "batch_size": 1}},
        "5": {"class_type": "KSampler", "inputs": {
            "model": ["1", 0], "positive": ["2", 0], "negative": ["3", 0], "latent_image": ["4", 0],
            "seed": seed, "steps": steps, "cfg": cfg, "sampler_name": sampler, "scheduler": scheduler, "denoise": 1.0}},
        "6": {"class_type": "VAEDecode", "inputs": {"samples": ["5", 0], "vae": ["1", 2]}},
        "7": {"class_type": "SaveImage", "inputs": {"images": ["6", 0], "filename_prefix": "p1000"}},
    }


def call(url, body=None):
    req = urllib.request.Request(url, data=json.dumps(body).encode() if body else None,
                                 headers={"Content-Type": "application/json"})
    return json.loads(urllib.request.urlopen(req, timeout=600).read())


def main():
    ap = argparse.ArgumentParser()
    ap.add_argument("--port", type=int, default=8188)
    ap.add_argument("--ckpt", required=True)
    ap.add_argument("--prompt", default="a beautiful sunset over mountains, photorealistic, golden hour, 4k")
    ap.add_argument("--negative", default="")
    ap.add_argument("--steps", type=int, default=20)
    ap.add_argument("--cfg", type=float, default=7.5)
    ap.add_argument("--seed", type=int, default=42)
    ap.add_argument("--size", default="512x512")
    ap.add_argument("--out", required=True)
    a = ap.parse_args()
    w, h = map(int, a.size.split("x"))
    base = f"http://127.0.0.1:{a.port}"
    t0 = time.perf_counter()
    pid = call(base + "/prompt", {"prompt": workflow(a.ckpt, a.prompt, a.negative, a.steps, a.cfg, a.seed, w, h)})["prompt_id"]
    while True:
        hist = call(f"{base}/history/{pid}")
        if pid in hist:
            break
        time.sleep(0.5)
    sec = time.perf_counter() - t0
    st = hist[pid].get("status", {})
    outs = [img for n in hist[pid]["outputs"].values() for img in n.get("images", [])]
    if not outs:
        print("失敗:", json.dumps(st, ensure_ascii=False)[:800])
        sys.exit(1)
    img = outs[0]
    q = urllib.parse.urlencode({"filename": img["filename"], "subfolder": img["subfolder"], "type": img["type"]})
    open(a.out, "wb").write(urllib.request.urlopen(f"{base}/view?{q}").read())
    print(f"OK {sec:.1f}秒 → {a.out}  ({st.get('status_str')})")


if __name__ == "__main__":
    main()
dt_bench.js … Draw Things の中で時間を測る(実験2)・36行
//@api-1.0
// p1000 Draw Things の計測:同じ文章・同じ種・同じ大きさで3回ずつ生成し、時間を記録する
const cfg = pipeline.configuration;
const prompts = [
  "a beautiful sunset over mountains, photorealistic, golden hour",
  "a close-up photo of hands holding a cup of coffee on a wooden table, natural light",
  "a street at night with a wooden shop sign that says \"OPEN\" and a neon sign that says \"MAC 2026\"",
  "日本の屋台、夜、赤い提灯に「ラーメン」と書かれている",
];
cfg.width = 1024;
cfg.height = 1024;
cfg.steps = 4;
cfg.guidanceScale = 1;
cfg.batchSize = 1;
cfg.batchCount = 1;
cfg.hiresFix = false;
cfg.seed = 42;
console.log("CONFIG " + JSON.stringify({model: cfg.model, sampler: cfg.sampler, steps: cfg.steps,
  guidanceScale: cfg.guidanceScale, width: cfg.width, height: cfg.height, shift: cfg.shift, seedMode: cfg.seedMode}));
console.log("PICTURES " + filesystem.pictures.path);
const times = [];
for (let i = 0; i < prompts.length; i++) {
  for (let r = 0; r < 3; r++) {
    canvas.clear();
    cfg.seed = 42;
    const t0 = Date.now();
    pipeline.run({configuration: cfg, prompt: prompts[i], negativePrompt: ""});
    const sec = (Date.now() - t0) / 1000;
    times.push(sec);
    console.log("RESULT prompt=" + i + " run=" + r + " sec=" + sec.toFixed(2));
    if (r === 0) {
      canvas.saveImage(filesystem.pictures.path + "/p1000_dt_p" + i + ".png", true);
    }
  }
}
console.log("ALL " + JSON.stringify(times));
参考サイト
- FLUX.2 [klein] 4B(Hugging Face)(Apache 2.0・4ステップ・ガイダンス1.0。9B版は非商用ライセンス)
- Stable Diffusion XL base 1.0(Hugging Face)(ライセンス条項「生成物の権利は主張しない」)
- CreativeML Open RAIL-M ライセンス(SD 1.5・第5条の用途制限と第6条の生成物)
- Draw Things(Mac・iPhone向けの画像生成アプリ)
- mflux(GitHub)(MLXで動く画像生成のコマンド)
- Diffusers(Hugging Face Docs)
- Comfy Desktop for macOS(ComfyUI Docs)(Mac用のアプリ版)
計測に使ったスクリプトは、付録のzipからそのまま使えます。お手元のMacで出た数字と、ぜひ比べてみてください 😊