GeForce NOWをMacで無料で使ってみた〜待ち時間と遅延を実測して分かった限界〜
GeForce NOWの無料プランをMacで実際に使い、待ち時間と遅延を実測しました。回線は599Mbpsでpingの損失は0%。それでもGeForce NOW自身の診断は「パケット配信19点/100点」。押してから画面が変わるまでは平均203msで、表示されるPING 21msの約10倍でした。
プログラミングや3DCGで何か作りたいと思っているエンジニアがいます
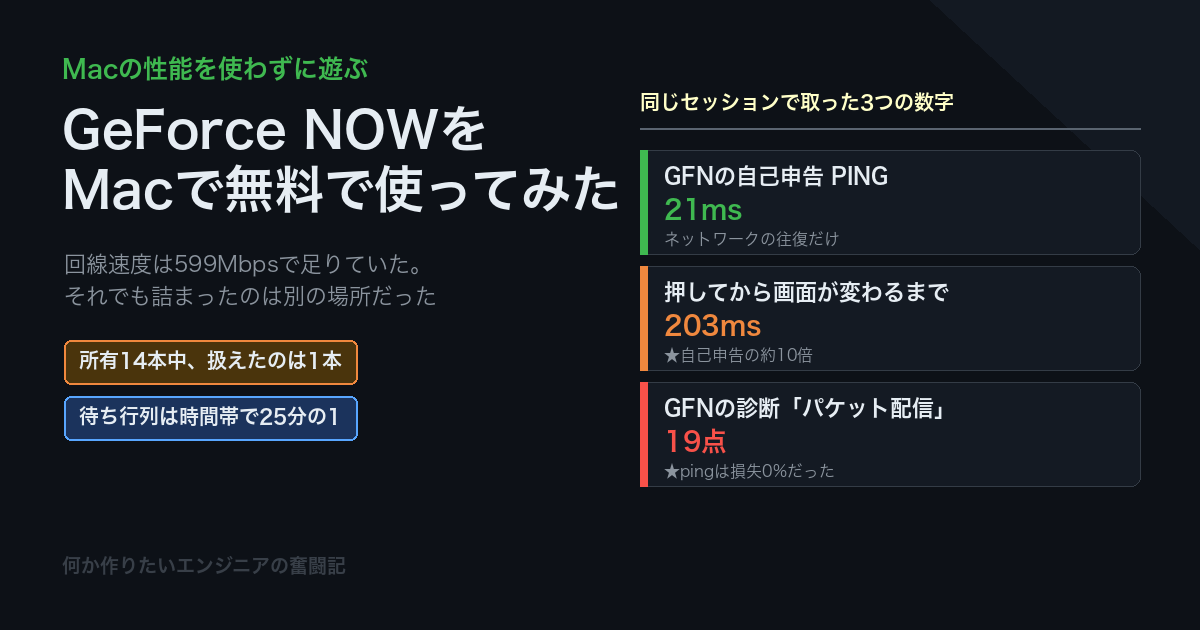
GeForce NOWの無料プランをMacで実際に使い、待ち時間と遅延を実測しました。回線は599Mbpsでpingの損失は0%。それでもGeForce NOW自身の診断は「パケット配信19点/100点」。押してから画面が変わるまでは平均203msで、表示されるPING 21msの約10倍でした。
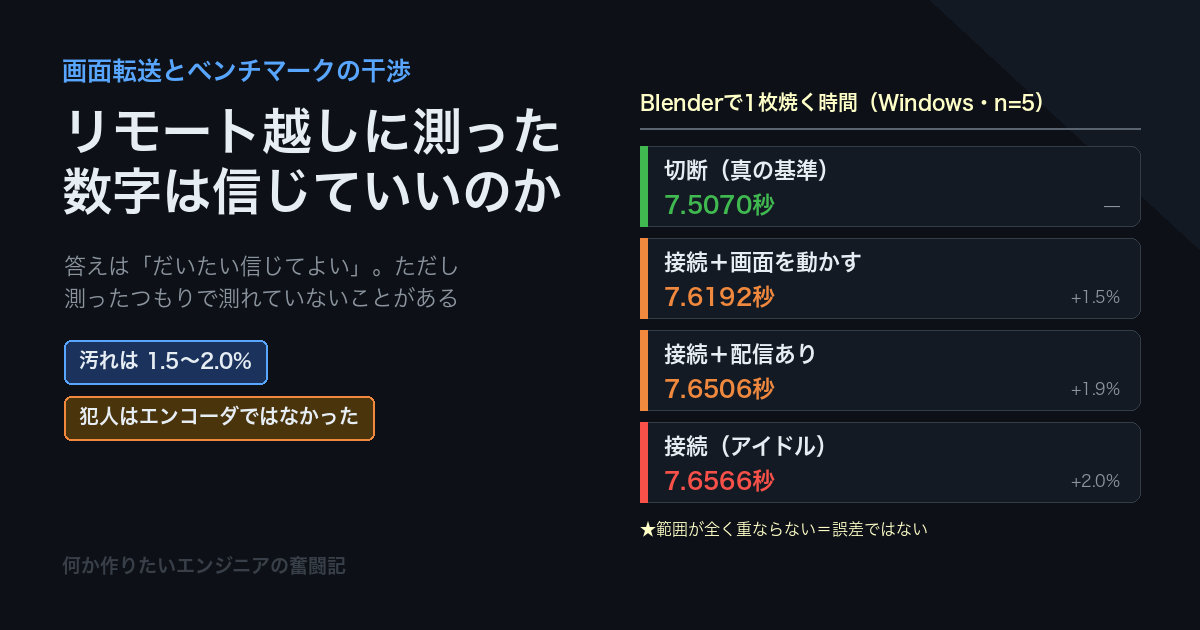
リモート接続したまま測ったベンチマークの数字は信じていいのか。Macで模擬負荷、Windowsで本物のDeskIn接続を実測しました。汚れは1.5〜2.0%。ただし犯人は映像エンコーダではなく、画面取得が使うGPUの3Dエンジンでした。
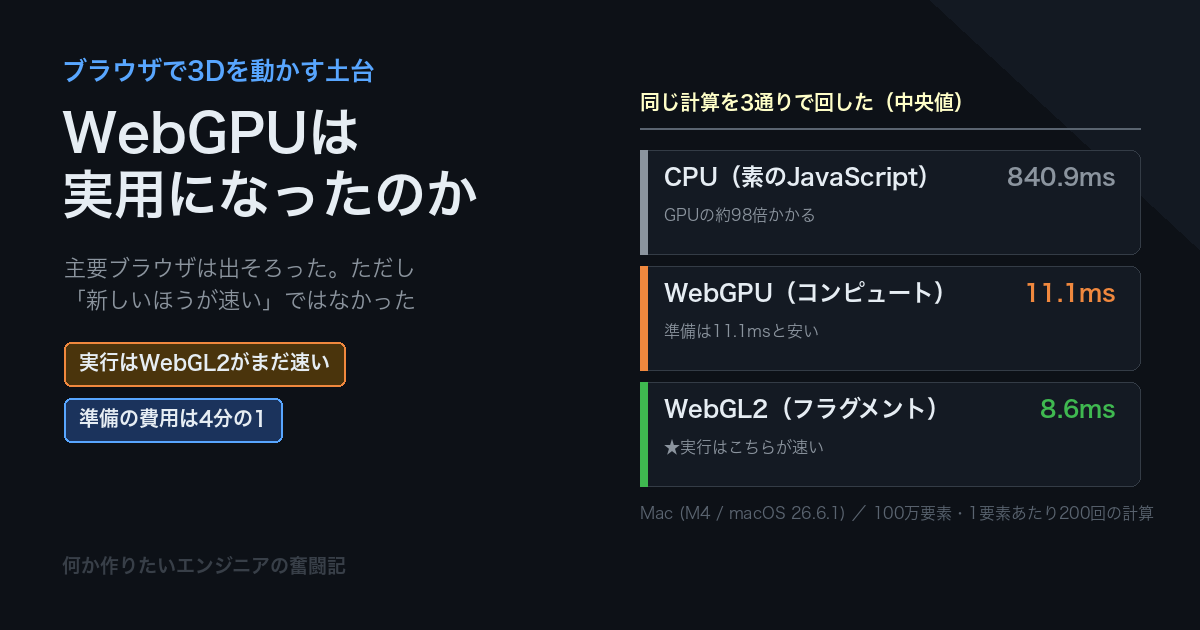
ブラウザで3Dや計算を動かす新しい土台WebGPUを実測しました。主要ブラウザは出そろいましたが、同じ計算ではWebGL2のほうが速く、シェーダを用意する費用はWebGPUが4分の1。WebGLに廃止予定は無く、実はWebGLもANGLE経由でMetalの上で動いています。手順とコードも全部載せました。

モデルを軽くする量子化は「賢さはほとんど落ちない」と言われます。本当かどうか、F16を1つ落として手元でQ8からQ2まで作り、perplexity・KL divergence・実際の出力の3つで測りました。数字の崖はQ3から。ところがQ2でもFizzBuzzは動き、17×24も当てます。崩れたのは日本語の説明文だけでした。さらに「日本語のほうが先に壊れるのでは」という予想を検証したところ、perplexityでは外れて見えたのにKL divergenceでは1.5倍脆いと出る——測り方で結論が変わる場面に行き当たった記録です。

AIの速さには tok/s・TTFT・スループットと色々な単位が出てきますが、「指示してから出力が終わるまで」は1つの数字では見られません。読み込む時間と書き出す時間に分けて足す、という見方を実測で確かめました。入力8千トークンでは最初の1文字まで39秒かかり、待ち時間の割合は7.9%から95.4%まで入れ替わります。さらに同時に使う人が増えると1人あたりは7分の1に落ちるのに全体の処理量は増える——同じ機械から3つの「速度」が出た記録です。