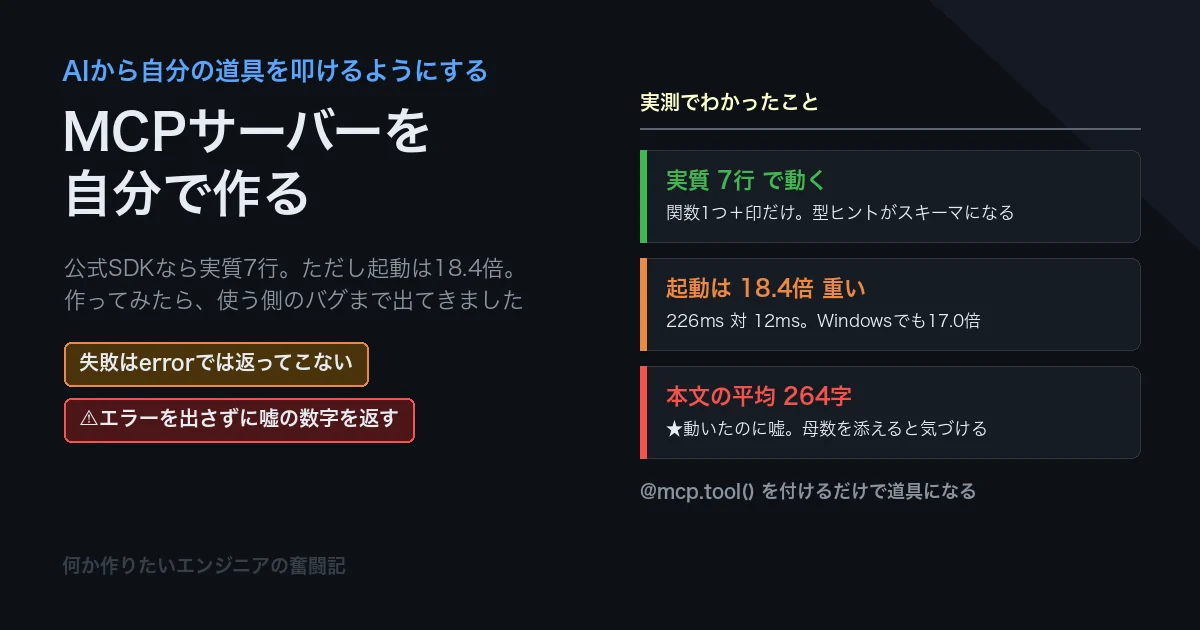
ローカルAIエージェントにMCPで外部ツールを繋ぐでは、既にある道具を「繋ぐ」側を作りました。今回は反対側です。自分の道具をAIに差し出すほう、つまりMCPサーバーを作ります。
やってみたら、思っていたより短く書けました。そして思っていたより、いくつも落とし穴がありました😅 いちばん驚いたのは、自分で作った道具が平気で嘘の数字を返してきたことです。しかもそれをきっかけに、このブログのサイト内検索が壊れていたことまで分かりました。
この記事は実験が6つあります(最後の1つはWindowsです)。「承前」と付いている章は、その前の章の続きです。
用語集
| 言葉 | 意味 |
|---|---|
| MCP | Model Context Protocol。AIに道具を渡すための共通の約束ごと。これに従って作れば、Claude Codeでも自作のエージェントでも同じサーバーが使える |
| MCPサーバー | 道具を提供する側のプログラム。「こういう道具があります」と名乗り、呼ばれたら実行して結果を返す。今回作るのはこちら |
| MCPクライアント | 道具を使う側。Claude Codeや自作エージェントがこれにあたる。p949で作ったのはこちら |
| 道具(tool) | サーバーが公開する関数1つぶん。名前・説明・引数の形をセットで持つ |
| JSON-RPC | 「この関数をこの引数で呼んで」をJSONで書いてやり取りする方式。MCPの土台になっている |
| stdio | 標準入力と標準出力。MCPの最も基本的な繋ぎ方で、サーバーを子プロセスとして起動し、その入出力で会話する。ネットワークを使わないので設定が要らない |
| スキーマ | 引数の形の説明書(型・必須かどうか・説明文)。AIはこれを読んで呼び方を決めるので、ここの出来がそのまま道具の使われ方になる |
| FastMCP | 公式SDKに入っている書きやすい書き方。関数に印を付けるだけで道具になる |
【下調べ】MCPサーバーは、結局なにを喋っているのか
作る前に、中で何が起きているかを1枚にしておきます。stdio方式のMCPは、驚くほど素朴です。1行1メッセージのJSONを、標準入出力で投げ合っているだけでした。
起動が1回、initialize と tools/list が1回ずつ、そのあとは tools/call を何度でも。この「起動は1回、呼び出しは何度でも」という形が、あとの実験1でそのまま効いてきます。
作るものを確かめるために、まず叩く側を用意しました。46行の小さなクライアントです。これがあると、AIを起動しなくてもサーバーの応答をそのまま目で見られます。
class Client:
    def __init__(self, argv):
        self.p = subprocess.Popen(argv, stdin=subprocess.PIPE, stdout=subprocess.PIPE,
                                  stderr=subprocess.PIPE, text=True, bufsize=1)
        self.id = 0

    def rpc(self, method, params=None, notify=False):
        msg = {"jsonrpc": "2.0", "method": method}
        if params is not None:
            msg["params"] = params
        if not notify:
            self.id += 1
            msg["id"] = self.id
        self.p.stdin.write(json.dumps(msg) + "\n")   # ★1行1メッセージ
        self.p.stdin.flush()
        ...

    def handshake(self):
        r = self.rpc("initialize", {"protocolVersion": "2024-11-05",
                                    "capabilities": {},
                                    "clientInfo": {"name": "probe", "version": "1.0"}})
        self.rpc("notifications/initialized", notify=True)   # ★返事を待たない通知
        return r
★ここを外すと動きません
initialize の返事をもらったあと、「初期化が終わりました」という通知を送る必要があります。これは id を持たない=返事が返ってこない種類のメッセージなので、返事を待つと固まります。
【実験1・Mac】最小のMCPサーバーは何行で書けるか
公式SDK(mcp 1.27.0)の FastMCP を使うと、こうなりました。これで全部です。
from mcp.server.fastmcp import FastMCP

mcp = FastMCP("blog-tools")


@mcp.tool()
def add(a: int, b: int) -> int:
    """2つの整数を足す"""
    return a + b


if __name__ == "__main__":
    mcp.run()
⚠先に読んでください ── この import は、いま入れると動きません
pip install mcp で入るのは2.x(執筆時点で 2.1.1)です。2.x では FastMCP が MCPServer に改名されていて、上のコードはこう言って止まります。
ModuleNotFoundError: No module named 'mcp.server.fastmcp'. This is mcp 2.x, where FastMCP was renamed to MCPServer …
エラー文が移行の案内まで書いてくれているので気づけます。書き換えるのは2行だけです。
# mcp 2.x(pip install mcp で入るのはこちら)
from mcp.server.mcpserver import MCPServer

mcp = MCPServer("blog-tools")     # ← ここだけ違う。@mcp.tool() も mcp.run() もそのまま
この記事の実測は 1.x(Mac 1.27.0 / Windows 1.29.1)で取っていますが、2.x でも引数スキーマとエラーの返り方は同じでした(実験2・3の結果は両方で確認しています)。違ったのは起動の重さだけで、Macで 1.x 226ms に対して 2.x は 308msです。古いコードをそのまま動かしたいときは pip install "mcp<2" で止められます。
空行とコメントを除いて実質7行。しかもこの短さで、必要なものは全部そろっています。
- 関数名がそのまま道具の名前になる
- docstringが説明文になる
- 型ヒント(
a: int)から引数のスキーマが自動で組み立てられる
さきほどのクライアントで叩くと、こう返ってきます。
$ python3 probe.py python3 min_fastmcp.py
serverInfo : {'name': 'blog-tools', 'version': '1.27.0'}
protocol   : 2024-11-05
起動+初期化: 248.8 ms
tools/list : 1.8 ms / 1個
  - add(a,b) : 2つの整数を足す
ちゃんと道具として名乗れています。ここまでは順調でした😊
【承前】同じものを、SDKなしで手書きしてみる
p949で繋いだ検証用サーバーは、SDKを使わず手書きのJSON-RPCでした。せっかくなのでまったく同じ道具を手書きでも書いて、並べてみます。
TOOLS = [{
    "name": "add",
    "description": "2つの整数を足す",
    "inputSchema": {
        "type": "object",
        "properties": {"a": {"type": "integer"}, "b": {"type": "integer"}},
        "required": ["a", "b"],
    },
}]


def handle(req):
    m = req.get("method")
    if m == "initialize":
        return {"protocolVersion": "2024-11-05",
                "capabilities": {"tools": {}},
                "serverInfo": {"name": "blog-tools-raw", "version": "1.0"}}
    if m == "tools/list":
        return {"tools": TOOLS}
    if m == "tools/call":
        a = req["params"]["arguments"]
        return {"content": [{"type": "text", "text": str(a["a"] + a["b"])}]}
    return None


for line in sys.stdin:
    ...
    if "id" not in req:          # ★通知には返さない
        continue
    sys.stdout.write(json.dumps({"jsonrpc": "2.0", "id": req["id"],
                                 "result": result}) + "\n")
    sys.stdout.flush()
実質33行。SDK版の4.7倍です。スキーマを手で書き、メソッド名で分岐し、通知には返さない、という当たり前のことを全部自分でやるので当然といえば当然です。
ところが、動かして測ると逆のことが起きました。7回ずつ測った中央値です。
| 実質行数 | 起動+初期化 | tools/list | tools/call | |
|---|---|---|---|---|
| SDK(FastMCP) | 7行 | 226.3 ms | 1.81 ms | 1.14 ms |
| 手書き JSON-RPC | 33行 | 12.3 ms | 0.04 ms | 0.03 ms |
| 比 | 4.7倍 | 18.4倍 | 45倍 | 38倍 |
★短く書けるほど、起動は重い
組み込みRustの回とまったく同じ形の結果になりました。あのときは「35行→14行で焼かれるサイズが約20倍」でした。楽をしたぶんが、どこかに乗っているという構図は言語もジャンルも越えて出てきます。
ただし、この数字は読み方に注意が要ります。前の章の図のとおり、起動は1回きり、呼び出しは何度でもです。そして呼び出しのほうは1.14msと0.03ms、どちらも人間には分からない差です。
つまり実際に効くのは「AIが道具を使い始めるまで0.2秒ぶん待つかどうか」だけ。常識的な用途なら、SDKの短さを取って何の問題もありません。手書きが効くのは、サーバーを頻繁に起動し直す作りにしてしまった場合です。
【承前・切り分け】210msはどこへ消えたのか
差が214msもあるので、どこに消えているのか測りました。それぞれ5回の中央値です。
| 測ったもの | 所要 |
|---|---|
python3 -c pass(Python自体の起動) | 10.2 ms |
import json, sys | 3.6 ms |
├ import pydantic | 33.1 ms |
├ import anyio | 36.2 ms |
from mcp.server.fastmcp import FastMCP | 206.9 ms |
★214msのほぼ全部が import でした。 SDKの実行が遅いのではなく、読み込むものが多いのが理由です。中で pydantic(スキーマの検証)と anyio(非同期の土台)を抱えていて、それだけで69ms。
これが分かると判断が変わります。「SDKは遅い」ではなく「SDKは起動が重い。しかも起動は1回だけ」です。数字を1つ見て決めず、内訳まで割ると結論が変わる、といういつもの話でした。
【実験2・Mac】引数の説明は「書いたつもり」では伝わらない
実用的な道具を書こうとして、引数に説明を付けました。Pythonでよく使うGoogle形式のdocstringです。
@mcp.tool()
def search_blog_posts(query: str, limit: int = 5) -> str:
    """ブログ記事を全文から検索し、新しい順に返す。

    Args:
        query: 検索語。本文・タイトル・タグのどこかに含まれる記事を探す
        limit: 返す件数(1〜20)
    """
これで tools/list がどう返るかを見て、あれ、となりました😳
"description": "ブログ記事を全文から検索し、新しい順に返す。\n\n    Args:\n        query: 検索語…(docstringが丸ごと入っている)",
"inputSchema": {
  "properties": {
    "query": { "title": "Query", "type": "string" },          ← ★説明が無い
    "limit": { "default": 5, "title": "Limit", "type": "integer" }
  },
  "required": ["query"]
}
★Args: に書いた説明は、引数のスキーマに入りません。 docstringは丸ごと道具の説明文になり、引数のほうには型と名前しか入っていません。
引数ごとに説明を持たせたいなら、書き方を変える必要があります。
from typing import Annotated
from pydantic import Field

@mcp.tool()
def b_field(
    query: Annotated[str, Field(description="検索語")],
    limit: Annotated[int, Field(default=5, ge=1, le=20, description="返す件数(1〜20)")] = 5,
) -> str:
    """Fieldで引数ごとに説明を付けた版。"""
両方を同じサーバーに入れて並べると、違いがはっきり出ました。
docstringの Args: | Field | |
|---|---|---|
引数の description | 入らない | 入る |
値の範囲(minimum/maximum) | 入らない | 入る(1〜20) |
| 書く量 | 少ない | やや多い |
では docstring は無駄なのか
そうでもありません。docstringは丸ごと説明文に入るので、AIは結局それを読みます。実害が出るのは範囲の制約のほうです。ge=1, le=20 を書いておくとスキーマに載り、しかもSDKが実際に弾いてくれます。説明で「1〜20です」とお願いするのと、機械が拒否するのとでは強さが違います。
【実験3・Mac】道具が失敗したとき、何が返るのか
道具は失敗します。ファイルが無い、引数がおかしい、権限が足りない。失敗をどう返すかは、サーバーを書く側がいちばん最初に決めるべきところです。
そこで、わざと4通りの失敗を起こして、クライアントに何が届くかを見ました。
① 道具の中で例外を投げた   raise ValueError("x=9 は受け付けられません")
② 範囲外の引数を渡した     ranged(n=999)     ← Field(ge=1, le=20)
③ 無い道具を呼んだ         no_such_tool
④ 必須の引数が無い         ranged()
結果は、4つとも同じ形でした。
| 失敗の種類 | JSON-RPCの error | result + isError |
|---|---|---|
| ① 例外を投げた | ならない | true「Error executing tool …: x=9 は受け付けられません」 |
| ② 範囲外の引数 | ならない | true「Input should be less than or equal to 20」 |
| ③ 無い道具 | ならない | true「Unknown tool: no_such_tool」 |
| ④ 引数が足りない | ならない | true「Field required」 |
★★道具の失敗は「エラー」ではなく「正常な応答」として返ってきます
プロトコルの error にはならず、中身に isError: true が立つだけです。
理由を考えると納得できます。失敗した理由をAIに読ませて、次の手を考えさせたいからです。プロトコルのエラーにしてしまうと、それはクライアントの通信層の問題になり、AIのところまで届きません。「ファイルが無い」と伝われば、AIは別のパスを試せます。
つまりサーバーを書く側は、素直に例外を投げてよいということです。SDKが受け止めて、AIが読める形に包んでくれます。逆に、例外を握りつぶして「失敗しました」という普通の文字列を返してしまうと、isError が立たず、失敗が失敗として伝わりません。
⚠【承前】自分のクライアントが、それを見ていなかった
ここで嫌な予感がしました。p949で書いた自作エージェント側のクライアントは、isError を見ていたでしょうか。
見ていませんでした😨
def call(self, tool, args):
    result = self._rpc("tools/call", {"name": tool, "arguments": args or {}})
    parts = []
    for c in result.get("content", []):
        if c.get("type") == "text":
            parts.append(c.get("text", ""))
    return "\n".join(parts)          # ★isError を一度も見ていない
実際に失敗する道具を呼んでみると、こうなります。
--- ① 成功する呼び出し ---
'記事 100本\n最新 p991\n…'

--- ② 失敗する呼び出し(存在しない道具)---
'Unknown tool: no_such_tool'          ← ★成功とまったく同じ形
★失敗が、成功と見分けのつかない形で返っていました。 文面から察することはできますが、機械的な目印がありません。
直したのは3行です。
text = "\n".join(parts) or json.dumps(result, ensure_ascii=False)
# ★道具の失敗は JSON-RPC の error では返ってこない。
#   result の中に isError:true が立つだけなので、見ないと成功と区別できない
if result.get("isError"):
    return f"⚠ 道具 {tool} は失敗しました: {text}"
return text
--- ② 失敗する呼び出し(存在しない道具)---
'⚠ 道具 no_such_tool は失敗しました: Unknown tool: no_such_tool'
作る側を1本書いてみて初めて、1年近く使っていた使う側のバグに気づきました。両側を書くと、片側だけでは見えないものが見えます。DLLの回で「両OSで測らないと結論が半分になる」と書きましたが、それと同じことでした。
【実験4・Mac】実用の道具を作る ── ブログを検索させる
足し算では面白くないので、実際に使うものを作ります。このブログの記事を検索して、統計を返す道具です。AIに「Rosettaの話、前に書いてたよね?」と聞けるようにする、という狙いです。
設計で決めたのは3つでした。
mcp = FastMCP("blog-tools")

# ★触ってよい場所は環境変数で受け取り、既定は持たせない。
#   サーバー自身が「どこまで触れるか」を持つのがMCPの安全側の作り方。
INDEX = pathlib.Path(os.environ.get("BLOG_INDEX", "")).expanduser()


def _load() -> list[dict]:
    if not INDEX.is_file():
        # ★例外を投げる。SDKがMCPの「道具のエラー」に包んでクライアントへ返す
        raise FileNotFoundError(
            f"索引が見つかりません: {INDEX or '(BLOG_INDEX が未設定)'}")
    return json.loads(INDEX.read_text(encoding="utf-8"))


@mcp.tool()
def search_blog_posts(query: str, limit: int = 5) -> str:
    """ブログ記事を全文から検索し、新しい順に返す。"""
    if not query.strip():
        raise ValueError("query が空です")
    limit = max(1, min(int(limit), 20))
    ...
- 道具名は「動詞_目的語」で具体的に。
searchではなくsearch_blog_posts。理由は実験5で書きます - 触ってよい場所は環境変数で外から渡す。 既定値を持たせない。サーバーの中に「どこまで触れるか」を閉じ込めるのがMCPの安全側の作り方です
- 失敗は素直に例外で投げる。 実験3のとおり、SDKが包んでAIに届けてくれます
動かすとこうなりました。
===== query='Rosetta' limit=3  (3.0 ms)
「Rosetta」: 4件(新しい順に3件)

p986 2026.08.15 Apple Siliconにネイティブ対応したゲームの探し方2026〜…
    「macOS対応」と書いてあってもApple Siliconネイティブとは限りません。…
    https://eight-engineering-blog.com/p986
p971 2026.08.02 Mac版Steamだけで何が遊べるのか〜ネイティブ対応の実情と、…
    …
3msで返ってきます。100本ぶんの索引を全部なめても、この規模ならまったく問題になりません😊
⚠【承前】動いたのに、返した数字が嘘だった
もう1つ、統計を返す道具も付けました。呼んでみると、こう返ってきます。
記事 100本 / 本文の平均 264字
最新 p991
本文の平均264字。 このブログの平均は7,000字を超えています。1桁どころか2桁近く違う😳
原因はすぐ分かりました。索引の b というフィールドを「本文」だと思って字数を数えていたのですが、これは検索用の抜粋で、600字で切ってあるものでした。しかも調べると、もっと悪いことになっていました。
索引の b: 最小 0 / 中央値 0 / 最大 600
→ 56/100本が本文なし
★中央値が0。100本のうち56本は、本文がひと文字も索引に入っていませんでした。 これは道具の問題ではなく、このブログのサイト内検索そのものの不具合です。
索引を作っている側の抜き出しかたを見ると、原因は2つでした。
re.search(r'<div class="article-body">(.*?)</div>\s*<div class="article-tags"', ...)
| 原因 | 本数 | 中身 |
|---|---|---|
| 閉じタグの直後にHTMLコメントがある | 54本 | </div><!-- .article-body --> のように書いてあると、\s* がコメントを飛び越えられない |
| 閉じタグ自体が無い | 2本 | 本文の </div> を書き忘れたまま公開されていた(記事HTML側のバグ) |
直したうえで、実害を測りました。⚠ここで一度、数え方を間違えかけました。「本文が全部入っていたら何件ヒットしたか」と比べると7倍などと出るのですが、索引は本文を600字で切っているので、それは索引が到達できない数字です。比べるべきは修正前と修正後でした。
| 索引が覆っていた本文 | 全本文に対する割合 | |
|---|---|---|
| 修正前 | 26,400字 | 3.4% |
| 修正後 | 60,000字 | 7.7%(2.3倍) |
| (本文の総量) | 780,834字 | 100% |
56本ぶんが戻ったので覆う量は2.3倍になりました。ただし、試した検索語(Vulkan・量子化・MCPなど7語)ではヒット件数が1件も増えませんでした。埋まった本文は各記事の頭600字だけで、それらの語はもっと後ろに出てくるからです。
★直したら、その奥にもっと大きい問題が見えた
本当の制約は600字という上限のほうでした。平均7,800字の記事に対して、検索の対象は先頭の7.7%だけです。
⚠「7倍取りこぼしていた」と書きかけて、やめました。 到達できない理想と比べた数字は、直した効果ではありません。
そこで上限も上げました。索引を読み込むのは検索ページを開いたときだけなので、重くなるぶんを払うのは検索する人だけです。
| 上限 | 索引サイズ | 本文の収録率 |
|---|---|---|
| 600字(元) | 211 KB | 7.7% |
| 2,000字(採用) | 546 KB | 25.6% |
| 4,000字 | 933 KB | 50.5% |
| 上限なし | 1,772 KB | 100% |
ここまでやって、ようやく検索結果が動きました。
| 検索語 | 直す前 | 本文の欠落を直した後 | 上限も上げた後 |
|---|---|---|---|
| Rosetta | 4件 | 4件 | 8件 |
| Vulkan | 2件 | 2件 | 7件 |
| 量子化 | 2件 | 2件 | 7件 |
| アンチチート | 1件 | 1件 | 3件 |
★真ん中の列が動いていないのが、この話のいちばんの教訓です。 56本ぶんの本文を取り戻しても、検索結果は1件も増えませんでした。不具合を直すことと、目的が果たされることは別でした。直したあとに測り直さなければ、「直したから良くなったはず」で終わっていたはずです。
★★AIは、道具が返した数字を疑えません
この道具はエラーひとつ出さずに動きました。返ってきた「平均264字」も、書式としては完璧です。もしAIに繋いだまま気づかなければ、AIはその数字を前提に考え続けていたはずです。
道具が返す値の正しさを保証できるのは、道具を書いた人だけです。「動いた」と「正しい」は別物、という話をこのブログでは何度も書いてきましたが、AIに道具を渡す場合はそこに「間違いが下流へ静かに広がる」が乗ります。
直したのは、数え方そのものです。
lens = [n for n in (_body_len(p["id"]) for p in posts) if n]
# ★数えられた記事だけで平均を出し、★母数を必ず添える。
#   「数えられなかったぶんを黙って0にする」と数字が静かに壊れる
if lens:
    lines.append(f"本文の平均 {sum(lens)/len(lens):,.0f}字"
                 f"({len(lens)}/{len(posts)}本から集計)")
else:
    lines.append("本文の字数は数えられませんでした(BLOG_HTML_DIR を確認してください)")
記事 100本
最新 p991
本文の平均 7,848字(96/100本から集計)
★母数を添えるのが肝です。「96/100本から集計」と書いてあれば、4本落ちていることが読んだ側に伝わります。数えられなかったぶんを黙って0として平均に混ぜるのが、いちばん静かに壊れるやり方でした。
【実験5・Mac】道具名の衝突は、どこで起きるのか
p949では、エージェントの内蔵の read_file とMCPサーバーの read_file がぶつかりました。作る側では、これをどう避ければいいのか。
まず、本当に衝突するのかを確かめます。同じ search という名前の道具を出すサーバーを2つ作って、同時に繋ぎました。
同じ名前の道具を2つのサーバが出したとき:
  server=alpha  name=search   desc=Aの検索
  server=beta   name=search   desc=Bの検索

  alpha/search → A が答えました: テスト
  beta /search → B が答えました: テスト
★MCPの層では衝突していません。 道具は必ず「どのサーバーの」という情報とセットで扱われるので、名前が同じでも区別が付きます。
では、p949では何が起きていたのか。クライアントがAIに道具一覧を渡すときに、平らにしていたのが原因でした。AIから見える一覧は「サーバー名つき」ではなく、ただの関数名の並びです。そこで初めてぶつかります。
使う側の対策(mcp__サーバー名__道具名 という名前空間を付ける)は p949 で実装済みです。ただしそれはクライアントがちゃんと作られていればの話。作る側でできるのは、最初から具体的な名前にしておくことです。
search は誰でも使いそうな名前ですが、search_blog_posts なら、平らにされてもまずぶつかりません。しかも名前を見ただけで何を探すのか分かるので、AIが選び間違えにくくなります。短い名前は、道具の世界では美点になりません。
【手順】Claude Codeに登録して使う
作ったサーバーをClaude Codeから呼べるようにします。コマンド1つです。
claude mcp add blog \
  --scope project \
  --env BLOG_INDEX=/path/to/search_index.json \
  --env BLOG_HTML_DIR=/path/to/cloudflare \
  -- /path/to/python3 /path/to/blog_mcp.py
すると、そのフォルダに .mcp.json ができます。
{
  "mcpServers": {
    "blog": {
      "type": "stdio",
      "command": "/path/to/python3",
      "args": ["/path/to/blog_mcp.py"],
      "env": {
        "BLOG_INDEX": "/path/to/search_index.json",
        "BLOG_HTML_DIR": "/path/to/cloudflare"
      }
    }
  }
}
⚠ここで1つ引っかかりました。登録したのに、一覧を見ると動いていません。
$ claude mcp list
Checking MCP server health…

blog: … - ⏸ Pending approval (run `claude` to approve)
★プロジェクトに置いた設定は、承認するまで動きません
これは安全側の設計です。.mcp.json はフォルダに置いてあるファイルなので、他人のリポジトリを開いただけで知らないプログラムが起動してしまっては困ります。だから一度だけ人間に確認する作りになっています。
「設定したのに動かない」と思ったら、まずここを疑ってください。
コマンドで書かず、絶対パスに気をつけて手で書いても同じです。ここは引っかかりやすいところなので、実験4で環境変数を使う作りにしておいたのが効きました。パスをコードに埋め込んでいたら、この設定ファイルだけでは切り替えられません。
【実験6・Windows】同じサーバーを、Windowsで動かす
MCPは標準入出力で1行ずつJSONをやり取りする方式です。ということは、Windowsに持っていったときに引っかかりそうな場所が最初から見えていました。改行コードと文字コードです。Windows機(RTX3060・Windows 11・Python 3.12.10)で同じものを動かしました。
結論から書くと、心配していた改行コードは問題なく、心配していた文字コードで盛大に転びました😅 しかも転んだのはサーバーではなく、eightが書いたクライアントのほうでした。
まず数字 ── 比は同じ、絶対値が3倍
| Mac(M4) | Windows | Windowsは | |
|---|---|---|---|
| SDK版の起動+初期化 | 226.3 ms | 630.4 ms | 2.8倍かかる |
| 手書き版の起動+初期化 | 12.3 ms | 37.1 ms | 3.0倍かかる |
| SDK ÷ 手書き | 18.4倍 | 17.0倍 | ほぼ同じ |
SDKの import | 206.9 ms | 596.8 ms | 2.9倍かかる |
★比はほとんど動きませんでした。 Windowsのほうが一律に約3倍遅いだけで、「SDKは起動が重い」という結論はOSを変えても同じです。実験1で「差の正体はimport」と切り分けておいたので、ここも import が2.9倍で素直に効いている、と読めます。
★★文字コード ── UTF-8で書いたものを、CP932で読んでいた
最初の実行は、こう落ちました(フォルダの部分は … で省略しました)。
=== 1. SDK版に繋ぐ ===
Traceback (most recent call last):
  File "C:\…\probe.py", line 25, in rpc
    line = self.p.stdout.readline()
UnicodeDecodeError: 'cp932' codec can't decode byte 0x99 in position 93: illegal multibyte sequence
原因はクライアント側でした。子プロセスを text=True で開くとき、encoding を書いていなかったのです。
# ⚠こう書いていた
self.p = subprocess.Popen(argv, ..., text=True, bufsize=1)
これだとその環境の既定の文字コードで読むことになります。Macでは既定がUTF-8なので何も起きません。日本語Windowsの既定はCP932なので、サーバーがUTF-8で書いた日本語を読んだ瞬間に落ちます。道具の説明文が「2つの整数を足す」という日本語だったので、tools/list の1回目で当たりました。
# ★encoding を書かないと、Windowsではロケール既定(CP932)で読んでしまう。
#   MCPはUTF-8なので、日本語が来た瞬間に UnicodeDecodeError で落ちる
self.p = subprocess.Popen(argv, ..., text=True, bufsize=1,
                          encoding="utf-8", errors="replace")
【承前】手書き版だけ通ってしまったのは、なぜか
不思議なことに、手書き版のサーバーだけは同じ状況でも普通に動いていました。日本語の説明文を持っているのは同じなのに、です。
理由は、両側が同じ間違いをしていたからでした。手書き版は sys.stdout.write() で書いています。ここも文字コードを指定していないので、Windowsでは CP932 で書き出していました。クライアントも CP932 で読むので、辻褄が合ってしまうわけです。
★★これは「動いた」のではなく「両方が同じだけ間違っていた」
MCPはUTF-8と決まっています。CP932で書き出すサーバーは仕様に違反しているので、自作のクライアントとは通っても、Claude Codeのような真っ当な相手に繋いだ瞬間に壊れます。
自分で両側を書いていると、こういう間違いはお互いに打ち消し合って表に出てきません。手書き版にも1行足しました。
sys.stdout.reconfigure(encoding="utf-8")
そしてもう1つ、同じ原因で落ちずに黙って化けるケースもありました。エラーの実験(実験3)の出力です。
"text": "Error executing tool raise_value_error: x=9 縺ッ蜿励¢莉倥¢繧峨l縺セ縺帙s"
本来は「x=9 は受け付けられません」です。UTF-8のバイト列をCP932として解釈すると、たまたま解釈できてしまうことがあり、そのときは例外にならず文字化けで済みます。★落ちてくれるほうがまだ親切で、こちらのほうが厄介でした。AIに繋いでいたら、化けた文字列をそのまま読ませることになります。
改行コードは、心配しすぎだった
いちばん警戒していた \r\n は、一度も問題を起こしませんでした。理由は単純で、json.loads() が前後の空白(改行を含む)を無視してくれるからです。1行1メッセージという素朴な作りが、ここでは効きました。
⚠自分のミス ── 同じ落とし穴を2回踏んだ
最初、Windows側では検証スクリプトそのものが動きませんでした。
cmd.exe : The syntax of the command is incorrect.
原因は、eightがMacで書いた .bat が改行LFのUTF-8だったことです。日本語Windowsの cmd はこれを読み損ねます。レンダリング高速化の回でまったく同じことを踏んで「.bat はASCIIのみ+CRLF」と書き残していたのに、書いた本人が再発させました😅 CRLFで書き直したら通っています。
Macと同じだったところ
残りは差がありませんでした。引数スキーマ(docstringの Args: は載らない/Field なら載る)も、エラーの返り方(4通りとも result + isError)も、Windowsでまったく同じ結果です。プロトコルの振る舞いはOSに依存しないことが確かめられました。
⚠なおWindows側に入っていたSDKは 1.29.1、Macは 1.27.0 でした。版が違っても上の結果は変わっていません。
つまずき集
| 症状 | 原因と対処 |
|---|---|
| サーバーが応答せず固まる | initialize のあとに notifications/initialized を送っていない。これは id を持たない通知なので、返事を待つと止まる |
| こちらが送った通知に返事を書いてしまう | 手書きサーバー側の話。id が無いメッセージには返さない。返すとクライアントが応答の対応関係を見失う |
| 引数の説明を書いたのに効いていない | docstringの Args: は引数のスキーマに入らない。Annotated[..., Field(description=...)] を使う(実験2) |
| 道具が失敗しているのに気づけない | 失敗は error ではなく result + isError: true で返る。クライアント側で見る(実験3) |
| 登録したのにClaude Codeで使えない | プロジェクトに置いた .mcp.json は承認待ちで止まる。claude を起動して承認する |
| 起動が妙に遅い | SDKの import で約210ms。サーバーを呼ぶたび起動し直す作りにしていないかを確認する(実験1) |
ModuleNotFoundError: mcp.server.fastmcp | 入っているのがSDK 2.x。MCPServer に改名されている。from mcp.server.mcpserver import MCPServer にするか pip install "mcp<2" で止める |
Windowsで UnicodeDecodeError: cp932 | ★クライアント側で Popen(..., encoding="utf-8") を指定していない。MCPはUTF-8だが、Windowsの既定はCP932(実験6) |
| Windowsで日本語が化ける(落ちはしない) | 同じくCP932。⚠落ちずに化けるほうが厄介。手書きサーバー側にも sys.stdout.reconfigure(encoding="utf-8") が要る |
Windowsで .bat が「構文が誤っています」 | Macで書いた .bat がLF改行。ASCIIのみ+CRLFで書き直す |
| 返ってくる数字が変 | ★道具の中身を疑う。AIは道具の返り値を検算してくれない(実験4の続き) |
まとめ
MCPサーバーは、身構えていたより簡単でした。公式SDKなら実質7行で、関数を1つ書いて印を付けるだけです。難しいのは繋ぐことではなく、渡す道具をまともに作ることのほうでした。
- ★短く書けるほど、起動は重い。 SDK 7行/226ms 対 手書き33行/12ms で18.4倍。ただし差の正体は
importの206msで、しかも起動は1回きり。呼び出しはどちらも2ms未満なので、普通の用途ならSDKで困りません - ★スキーマは「書いたつもり」になりやすい。 docstringの
Args:は引数の説明として載りません。Fieldなら説明も値の範囲も載り、しかも範囲は実際に弾いてくれます - ★★道具の失敗は「エラー」として返ってきません。
resultの中にisErrorが立つだけです。AIに理由を読ませて次の手を考えさせるための設計で、理にかなっています。ただし使う側がそれを見ていないと、失敗が成功として通ります——eightの自作クライアントがまさにそうでした - ★★いちばん怖いのは、エラーも出さずに間違った値を返す道具です。 「本文の平均264字」は書式としては完璧で、AIには疑いようがありません。母数を添えるだけでも、読んだ側が異常に気づけます
- ★Windowsでも結論は変わりませんでした。 起動の比は 17.0倍(Macは18.4倍)で、絶対値が一律に約3倍遅いだけ。スキーマもエラーの返り方も同じです。★★ただし文字コードで転びました——MCPはUTF-8なのに、クライアントがWindowsの既定(CP932)で読んでいたのが原因です。⚠しかも手書きサーバーだけは通ってしまいました。両側とも同じ間違いをしていて辻褄が合っていただけで、真っ当なクライアントに繋げば壊れます
- ★道具名は具体的に。 衝突するのはMCPの層ではなく、AIに平らな一覧として渡す瞬間です。作る側で長い名前にしておけば、使う側の実装がどうであれ効きます
そして今回いちばん収穫だったのは、作る側を1本書いたら、1年近く使っていた使う側のバグと、サイト内検索の不具合が芋づるで出てきたことでした。両OSで測ると結論が変わるのと同じで、両側から見ると、片側では見えないものが見えます😊
参考サイト
この記事で外から持ってきた事実(SDKの版・改名・仕様)の出どころです。数値と実測結果は、すべて手元の環境で測ったものです。
- Model Context Protocol 公式サイト ── プロトコルの一次情報
- MCP 仕様(2024-11-05) ── この記事で握手に使っている
protocolVersionの版 - Python SDK(modelcontextprotocol/python-sdk) ── FastMCP / MCPServer の実装
- PyPI: mcp ──
pip install mcpで入る版の確認(執筆時点で 2.1.1) - SDK 2.x への移行ガイド ── ★FastMCP が MCPServer に改名された件。実験1のエラーメッセージ自体がこのURLを案内してくる
- Claude Code の MCP 設定 ──
claude mcp addと.mcp.jsonの仕様
実測の環境:Mac は Apple M4 / メモリ32GB / macOS 26.5.2 / Python 3.12.5 / mcp 1.27.0(2.x の確認は 2.1.1)。Windows は Windows 11 / Python 3.12.10 / mcp 1.29.1。⚠版が変われば数字も変わります。
それでは、今回はここまで。最後までありがとうございました😊