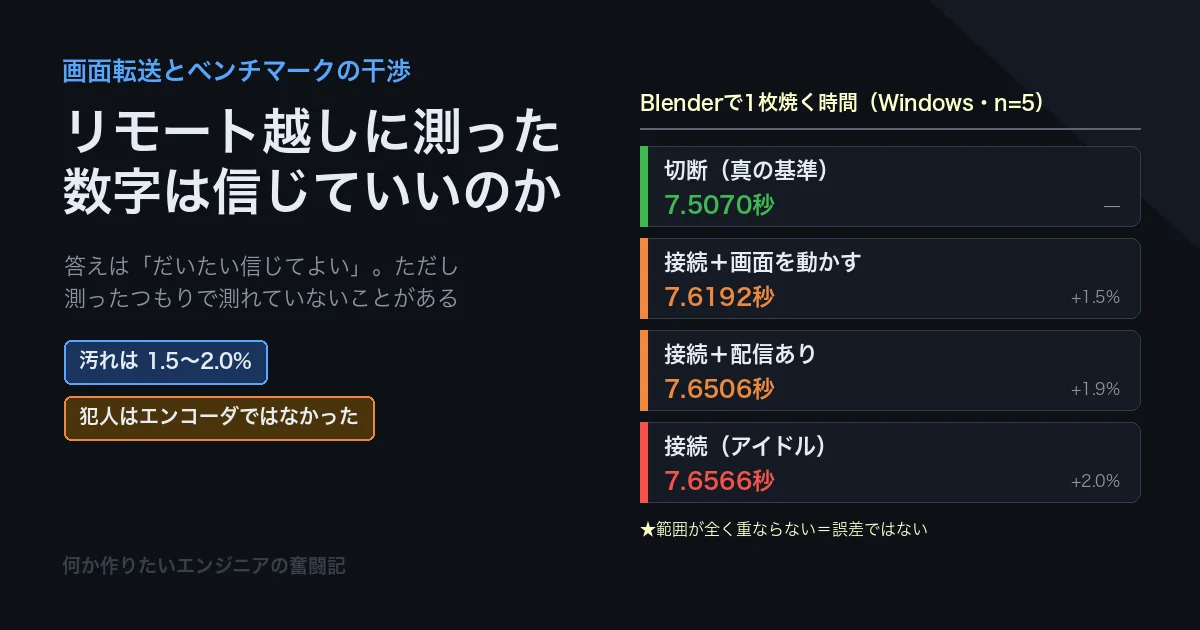
Blenderのレンダリング時間やAIの生成速度を測るとき、eightはよくWindows機を使っています。ただそのWindows機は常に手元にあるわけではなく、離れた場所からリモート接続して操作することがあります。
そこで気になったのが、これです。
画面を転送するということは、その裏で「画面をつかんで、圧縮して、送る」という仕事が動いているはずです。 それがベンチマークの結果に混ざっていたら、載せている数字は少しずつ嘘になります。
気になったので測りました。実験はMacで7つ、Windowsで4条件です。章タイトルに【承前】と付いている章は、直前の章の続きになっています。
この記事でわかること
- ★本物のリモート接続で汚れるのは 1.5〜2.0%。思っていたよりずっと小さい
- ★★Macで自作した模擬負荷と、本物の接続とで、結論が逆向きになった。その理由
- ★★映像エンコーダ(NVENC)は1%も使われていなかった。犯人は別のところにいた
- ★負荷そのものを揃えないと、結論がひっくり返るという測り方の落とし穴
- ★★いちばん危ないのは「接続しているのに、実は何も流れていない」状態だった
- 切断してもベンチが走るかどうかは、接続ソフトの方式で決まる
用語集
| 用語 | 平たく言うと | なぜそれが効くのか |
|---|---|---|
| 符号化(エンコード) | 画面の絵を圧縮して、送れる大きさにすること | ここが重ければ、そのぶん本来の計算が邪魔される |
| NVENC | NVIDIAのGPUに載っている、映像圧縮専用の回路 | ★計算用の回路とは別なので「取り合いにならない」はず、というのが今回の前提だった |
| 3Dエンジン | GPUの中で、絵を描く計算をする部分 | ★Cyclesのレンダリングもここを使う。取り合いが起きる場所 |
| DXGI Desktop Duplication | Windowsが用意している「画面をまるごと取り込む」仕組み | リモート接続ソフトが画面をつかむときに使う |
| OptiX / Metal | BlenderがGPUを使うときの経路。OptiX=NVIDIA、Metal=Apple | 今回はどちらもGPUで焼いている |
| タスクスケジューラ | Windowsで「この時刻にこれを実行して」と予約する仕組み | ★接続を切った状態で測るために必要になる |
| 1枚あたりの時間 | Blenderで画像を1枚焼き上げるのにかかる秒数 | 今回のものさし。小さいほど速い |
【下調べ】リモート接続は、向こう側で何をしているのか
まず、何が負荷になり得るのかを整理します。リモートデスクトップがホスト(操作される側)でやっているのは、大きく3つです。
そして、②の符号化は専用の回路(NVIDIAならNVENC、AppleならVideoToolbox)でやるのが普通です。計算用の回路とは別物なので、理屈のうえでは「取り合いにならないから汚れないはず」とも言えます。
この見込みが当たっているのかを確かめる、というのが今回の出発点でした。
【実験の準備・Mac】本物が手元に無いので、3工程を自分で作る
Mac側では、本物のリモート接続ではなく①と②を自分で走らせて負荷にしました。ffmpegで映像を作り、符号化し続けさせます。
| 負荷の名前 | 中身 |
|---|---|
none | 何も動かさない(基準) |
hw | 1920×1080の映像を h264_videotoolbox(GPU側の専用回路)で符号化し続ける |
sw | 同じ映像を libx264(CPU)で符号化し続ける |
hwbig | 3600×2338(実画面と同じ画素数)を hw で符号化 |
cap | 実画面を取り込んで hw で符号化(①の費用込み) |
ものさしは2つ。Blender Cyclesで1枚焼く時間(p977と同じ room.blend・1280×720・128サンプル)と、AIの推論速度(llama-bench・Qwen2.5-Coder-7B Q4_K_M)です。
測り方の約束を先に決めました。
- ★ウォームアップを1枚焼いて捨てる(p976の教訓。そのマシンで最初にGPUへ仕事を投げたときだけ余計に時間がかかる)
- ★順序をABBAにする(none→hw→sw→sw→hw→none)。時間が経つほど熱で遅くなるので、その傾きを相殺する
- 負荷は測定開始の6秒前に起動し、安定してから測る。各条件 n=6
【実験1・Mac】★負荷を揃えないと、結論がひっくり返った
最初の測定では、ffmpegに上限を付けず「出せるだけ」符号化させていました。結果はこうです。
| 条件 | 1枚あたり | 対 none |
|---|---|---|
| none | 9.40秒 | — |
| hw(230fps出ていた) | 10.47秒 | +11.4% |
| sw(380fps出ていた) | 12.39秒 | +31.8% |
これを見ると「CPUで符号化するほうが悪影響が大きい」と結論したくなります。ところが、よく見ると負荷そのものの量が1.6倍違っています(230fps 対 380fps)。重い仕事をたくさんさせているほうが邪魔をするのは、当たり前です。
実機の画面転送は30fpsで動くので、-re を付けて両方30fpsに固定して測り直しました。
| 条件 | 1枚あたり | 対 none |
|---|---|---|
| none | 9.32秒 | — |
| hw(30fps) | 10.15秒 | +8.9% |
| sw(30fps) | 9.59秒 | +2.9% |
揃えたあとは「GPU側で符号化するほうが悪い」です。 「負荷あり/なし」を比べる実験では、負荷そのものを実機と同じ条件に固定しないと意味がありません。 危うく逆のことを書くところでした😅
【実験2・Mac】汚れの量を決めていたのは「何画素送るか」
| 負荷(すべて専用回路で符号化・30fps) | 1枚あたり | 対 none |
|---|---|---|
| none | 9.32〜9.47秒 | — |
| 1920×1080 | 10.15秒 | +8.9% |
| 3600×2338(合成映像) | 12.29秒 | +29.8% |
| 3600×2338(実画面を取り込む) | 12.38秒 | +31.1% |
★注目したいのは下2本の差がわずか1.3ポイントしかないことです。合成した映像を符号化するのと、実画面を取り込んでから符号化するのとで、ほとんど変わりません。
つまり「画面を取り込む」工程(①)はほとんどタダで、効いていたのは画素数でした。Retinaの解像度をそのまま送ると3割持っていかれます。
【実験3・Mac】AIの推論はほとんど汚れない ── ただし熱のほうが大きい
| 負荷 | pp512(読解) | tg128(生成) |
|---|---|---|
| none | 233.6 tok/s | 20.97 tok/s |
| hw | 232.3(−0.6%) | 20.84(−0.6%) |
| sw | 234.5(+0.4%) | 20.60(−1.8%) |
差は±2%以内で、ほとんど影響がありません。ところが、ここで別のものが見えました。
none でも、1回目 239.3 → 6回目 227.9 tok/s(−4.8%)条件の違い(±1.8%)より、時間が経つことによる低下のほうが大きいのです。 ABBA順にしていなければ、この落ち込みを「負荷のせい」と読み違えていました。
【実験4・Mac】逆向きの干渉 ── 画面側が落ちるほうはどうか
ここまでは「画面転送がベンチを汚すか」でしたが、逆も気になります。重いレンダリング中に、リモート画面のほうがカクつくのかです。
| 符号化 | 単独 | レンダ中 | 変化 |
|---|---|---|---|
| 専用回路 1920×1080 | 233.1 fps | 231.2 fps | −0.8% |
| 専用回路 3600×2338 | 60.5 fps | 60.4 fps | −0.2% |
| CPU 1920×1080 | 443.3 fps | 351.9 fps | −20.6% |
★非対称でした。専用回路で符号化していれば奪われませんが、CPUで符号化していると2割持っていかれます。「リモート操作がカクつくかどうか」は、転送側が専用回路を使えているかで決まる、ということになります。
【ここまでの見込み】Mac側で立てた処方箋
ここまでの数字から、こんな処方箋を書きました。
- 転送する解像度を下げるのがいちばん効く(+30% → +8.9%)
- 専用回路を使う転送方式を選ぶ(逆向きの干渉も避けられる)
- GPUの数字は接続を切って測る。CPU中心の数字は接続中でも信用してよい
ただし——ここまでで測ったのは自分で作った模擬の負荷であって、本物のリモートデスクトップではありません。ここが後で効いてきます。
【実験の準備・Windows】本物のリモート接続で測り直す
ここからWindows機(Ryzen 7 7840HS / RTX 3060)です。接続ソフトは DeskIn、同一LANのP2P接続、転送解像度は1920×1080(倍率1.0)。画面の取り込みは DXGI Desktop Duplication でした。
Blenderは同じ room.blend・1280×720・128サンプル、経路はOptiX。各条件 n=5 です。Macと同じシーン・同じ設定なので、そのまま並べられます。
確かめたいことは3つ。
- 接続なしの数字(真の基準)。★そもそも切断中に測れるのかが論点
- NVENCが本当に動いているか。Macでは経路を確定できなかった
- 転送の解像度を下げると軽くなるか
【実験5・Windows】そもそも切断中にベンチが走るのか
接続を切ってしまったら、画面もキーボードもありません。その状態でベンチマークが動くのかは、やってみないと分かりません。タスクスケジューラに予約してから接続を切るという形にしました。
schtasks /Create /TN p984_disconnected /SC ONCE /ST 20:33 ^
  /TR "cmd /c C:\p984\run_windows.bat disconnected" /F
※ C:\p984\ の部分は、run_windows.bat を置いたフォルダに合わせて書き換えます。
結果は成功でした。20:33:40に結果ファイルが生成され、タスクの終了コードは0。ログには cycles_device: GPU / devices: NVIDIA GeForce RTX 3060 と出ており、GPUレンダリングも普通に動いています。
★これは接続ソフトの方式によります。DeskInはもともと画面に出ているセッションに相乗りする方式なので、接続を切ってもセッションが消えません。実際 query session でも console が Active のままでした。
/RL HIGHEST を付けると登録できない最初は手順に
/RL HIGHEST(最上位の権限で実行)を入れていましたが、
昇格が必要で Access denied になります。
ベンチマークに管理者権限は要らないので、外せば通常の権限で登録できます。
【実験6・Windows】接続していると 1.5〜2.0% 遅い
| 条件 | 配信fps | 平均 | 最小〜最大 | 対 切断 |
|---|---|---|---|---|
| 切断 | — | 7.5070秒 | 7.4916〜7.5259 | — |
| 接続+画面を動かす | 約1〜2 | 7.6192秒 | 7.6022〜7.6291 | +1.49% |
| 接続+配信が乗った状態 | 約3.8〜5.4 | 7.6506秒 | 7.6233〜7.6724 | +1.91% |
| 接続(アイドル) | 約1〜2 | 7.6566秒 | 7.6471〜7.6677 | +1.99% |
差は小さいのですが、これは誤差ではありません。
★切断のいちばん遅い回(7.5259秒)が、接続中のいちばん速い回(7.6022秒)より速いのです。範囲が完全に分かれています。各条件の内部のばらつきは0.3〜0.6%しかありません。
【承前】熱のせいではないことを潰しておく
「切断の回だけ冷えていたから速かったのでは?」という疑いが残ります。実験3で熱ドリフトに引っかかりかけたので、ここは潰しておきます。
| 条件 | GPU温度 | GPU使用率 | 電力 |
|---|---|---|---|
| 切断 | 48〜64℃ | 最大97% | 最大113.7W |
| 接続+画面を動かす | 48〜64℃ | 最大96% | 最大112.5W |
| 接続+配信 | 50〜64℃ | 最大96% | 最大112.5W |
| 接続(アイドル) | 50〜64℃ | 最大96% | 最大113.1W |
★最大温度は4条件とも64℃でぴったり同じ、使用率も電力も揃っています。しかも切断の回はいちばん最後(20:33)に測っています。冷えていたどころか、いちばん温まっているはずの順番です。熱ではありません。
そして配信fpsを5倍(1〜2fps → 3.8〜5.4fps)にしても、7.6192秒 → 7.6506秒とほとんど動きません。★汚しているのは「転送量」ではなく「接続していること」そのもののようです。
【実験7・Windows】★NVENCは、1%も使われていなかった
ここが今回いちばん驚いたところです。nvidia-smi で映像エンコーダの使用率を見張りました。
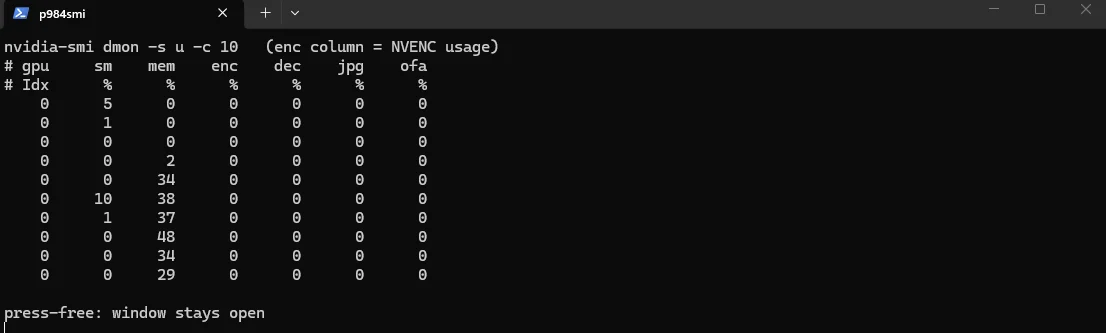
enc の列が全部ゼロです。これは接続中に撮ったもので、しかも4条件・全サンプル(各37〜49回)で最大0%でした。念のためWindows側のGPUカウンタで全アダプタの映像エンコード用エンジンも見ましたが、一度も0を超えません。
ところが、DeskIn自身の設定ログにはこう書かれています。
support_gpu : NVIDIA GeForce RTX 3060#, enableTestHWCodec : 1, enableHW: 1
codec: {"default_hard_codec":"h264","default_soft_codec":"vp8"}
Using DXGI capturer「ハードウェア符号化は有効」と自称しているのに、使用率としては観測できないという状態です。1〜5fpsという低さでは1秒ごとの測定では0%に丸まってしまうか、あるいは実際にソフトウェア側で処理されているのだと思われます。
【承前】では何がGPUを食っていたのか ── 犯人は3Dエンジン
エンコーダが0%なら、あの2%はどこから来たのか。GPUの中を仕事の種類ごとに見ていったところ、見つかりました。
画面が変化しているかどうかに関係なく、ほぼ一定です(瞬間的な最大は13.6%)。
3Dエンジンは、Cyclesがレンダリングに使うのと同じ場所です。約2%持っていかれる → Blenderが約2%遅くなる。数字がきれいに一致します。
干渉の正体は「エンコーダとの取り合い」ではなく、画面の取り込みと合成が3Dエンジンを食っていることでした。Mac側で「①画面をつかむ工程はほとんどタダ」と結論していたのですが、本物の接続では、そこがずっと居座り続けます。
【ここから整理】★MacとWindowsで結論が逆向きになった
| Mac(自作の模擬負荷) | Windows(本物のDeskIn) | |
|---|---|---|
| 効いていたもの | ★画素数(1080p +8.9% → 高解像度 +29.8%) | ★接続していること自体(転送量は無関係) |
| 汚れの大きさ | 最大 +31.1% | +1.5〜2.0% |
| 符号化の経路 | GPUの専用回路 | ★エンコーダは0%。3Dエンジンが約2% |
なぜここまで違ったのか。理由ははっきりしています。
Macでは「リモート接続=30fpsで送り続けている」と考えて負荷を作りました。ところが 本物のDeskInは、画面が静止していると1〜2fpsまで落ちます。 送る絵が変わらなければ、送る必要が無いからです。
つまり転送量そのものが小さく、画素数が効く余地がありませんでした。 代わりに残ったのが、画面を見張り続けるために常駐している部分の一定コストだったわけです。
模擬実験が間違っていたというより、模擬するときに置いた仮定が実物と違っていたということになります。自分で負荷を作るタイプの実験では、ここがいちばん危ないところだと思いました。
【整理】★いちばん危なかったのは「測ったつもりで、測れていない」
そして、この回でいちばんヒヤリとしたのがこれです。
最初に「接続中」として測った回は、接続こそ確立していたものの、クライアントの画面が前面に無く、1.7fpsしか流れていませんでした。つまり「接続しているのに、ほとんど何も送っていない」状態です。
それを「接続中の値」として採用していたら、「接続しても汚れない」という誤った結論になっていました。
区別できた手がかりは、意外なところにありました。nvidia-smi ではありません。DeskIn自身のログです。
19:49:16: session send  48 frame, recv 3408 mouse 338 key 0 text.   ← アイドル(約1.6fps)
20:24:16: session send 161 frame, recv 16251 mouse 338 key 0 text.  ← 稼働(約5.4fps)
session send N frame が30秒ごとの実送信フレーム数、つまり正確なfps計になっていました。recv ... mouse ... が増えていれば、クライアントから入力が届いている=本当に人が見ている証拠にもなります。
そこで、送信フレーム数が閾値(30秒あたり150枚)を超えたのを検出してから、自動でベンチを回す仕掛けを入れました。表の「接続+配信が乗った状態」は、その条件を満たしてから測ったものです。
あのときは「ベンチマークは動いたが、確かめたかった仕組みを1ミリも通っていなかった」。 今回は「負荷を掛けたつもりで、掛かっていなかった」。
どちらも画面上は成功していて、エラーも出ません。 自己申告のログを探しに行かないと、最後まで気づけない種類の間違いです。
【整理】結局、リモート越しの数字は信じていいのか
測った範囲での答えです。
| 測るもの | リモート接続中に測ってよいか |
|---|---|
| AI推論の tok/s | ◎ ほぼ影響なし(±2%)。ただし熱による低下のほうが大きいので順序を揃える |
| GPUレンダの時間 | ○ 1.5〜2.0%は遅くなる。小数点以下2桁で比べるなら切って測る |
| 数%を争う比較 | △ 切って測る。差より汚れのほうが大きくなる |
| 10%以上の差を見る比較 | ◎ 接続したままで問題ない |
実用上の結論としては、「だいたい信じてよい」です。2%というのは、記事で「1.5倍速くなった」といった話をするぶんには埋もれる大きさです。
ただし条件が2つあります。
- 切って測れるなら切る。タスクスケジューラに1行登録するだけで、真の基準値が手に入ります
- ★「接続している」と「配信されている」は別物なので、後者を確かめる。これを取り違えると、汚れを過小評価します
つまずき集
- ⚠
schtasks /Createに/RL HIGHESTを付けると Access denied。ベンチに管理者権限は要らないので外す - ⚠
nvidia-smiのエンコーダ列では、接続の状態を区別できない。常に0なので「配信中かどうか」が分からない。接続ソフト自身のログを見るほうが確実 - ⚠逆向きの干渉を測るとき、最初は
-t 30で「30秒ぶんの映像」を指定してしまった。負荷が始まる前に符号化が終わっており、900フレーム固定で差が出なかった。実時間で窓を切り、その間のフレーム数を数える形に直した - ⚠さらに「Blenderが本当に動いていたか」の確認フラグを終了処理のあとに評価していて、常にfalseだった。★確認用のフラグは、確認したい瞬間に取る
- ⚠切断中のスクリーンショットは、原理的に撮れません😅 画面を撮る人がいないからです。数値はテキストで残しました。同じく、クライアント側の設定画面もホスト側からは撮れないので、接続パラメータはホストのログから拾いました
まとめ
- 本物のリモート接続で汚れるのは 1.5〜2.0%。範囲が重ならないので誤差ではないが、実用上は小さい
- ★★犯人は映像エンコーダではなかった。使用率は全条件で0%。実際に食っていたのは画面取得が使う3Dエンジンの約2%
- ★★Macの模擬実験とは結論が逆向きになった。「30fpsで送り続けている」という仮定が実物と違っていた(本物は静止画で1〜2fpsまで落ちる)
- ★負荷を揃えないと結論がひっくり返る。上限を付けずに測った回では、逆のことを書きかけた
- ★★いちばん危ないのは「接続しているのに配信されていない」状態。エラーも出ず、画面上は正常に見える
- 切断中でも測れるかは接続ソフトの方式次第。相乗りする方式ならセッションが生き残る
- 熱の影響は思ったより大きい。★条件の差(±2%)より、時間経過による低下(−4.8%)のほうが大きいことがある
「リモートで測った数字は信じていいのか」という問いから始めましたが、いちばんの収穫は汚れの大きさではなく、測り方のほうにありました。負荷を掛けたつもりで掛かっていない、という状態が本当にあると分かったのが収穫です😊
それでは、今回はここまで。最後までありがとうございました😊