ここ数か月、手元のパソコンだけで動くAIをいろいろ作ってきました。検索とPC操作ができるエージェント、声で話せるアシスタント、オフラインのコーディング相棒、自分のブログ全記事を読ませたAI検索、MCPで外部ツールを繋いだ回……。1本ずつは動くのですが、「結局どこから作ればいいのか」を書いた記事が1本もありませんでした😅
今回はそれを1本にまとめます。ネットに繋がず、1円も払わず、手元のMacだけで動くAIエージェントを、何もない状態から組み上げます。
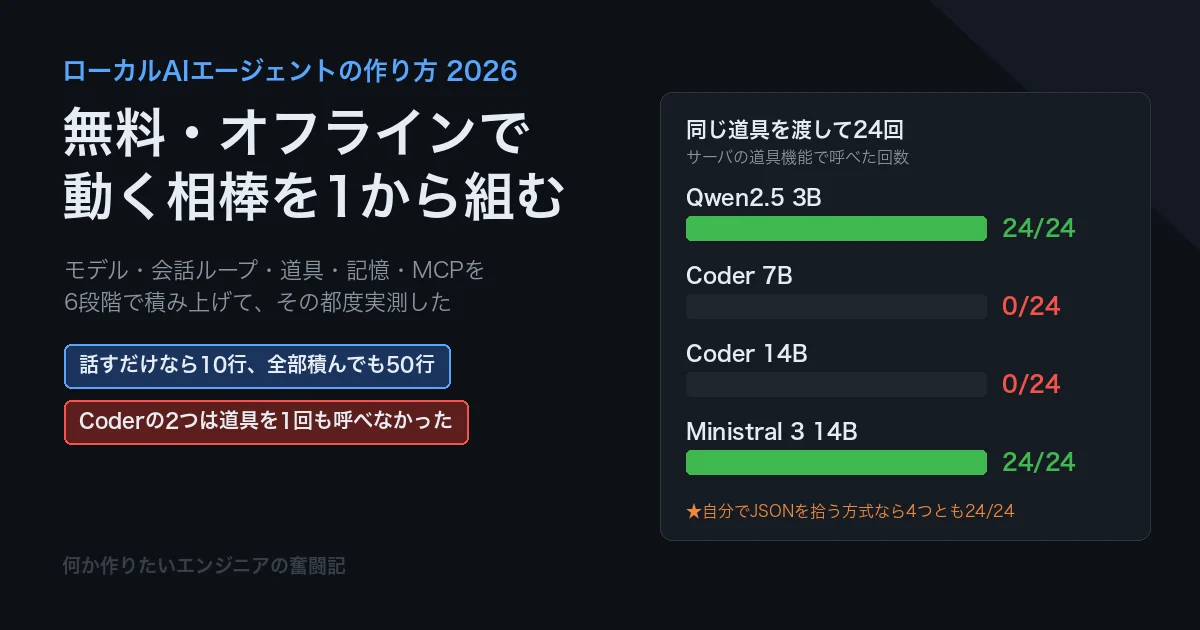
作りながら測っていたら、いちばん面白かったのは速度でも賢さでもなく、同じ道具を4つのモデルに渡したら、2つは1回も呼べなかったことでした。しかも呼べなかったのは、コードを書くのが得意なCoderの2つでした。同じ14Bでも、Ministral 3は満点です。
この記事は下ごしらえが1つ、段階が6つ、実測が3つあります。
先に実測した環境を書いておきます。★この記事の数字はこの環境のものです。
| 項目 | 内容 |
|---|---|
| パソコン | Apple M4 / メモリ32GB / macOS 26.6.2 |
| 推論 | llama.cpp b10090(Homebrew版・Metal)/ Ollama 0.24.0 |
| モデル | Qwen2.5 3B Q4_K_M / Qwen2.5-Coder 7B・14B Q4_K_M / Ministral 3 14B Q4_K_M(すべて量子化 Q4_K_M) |
| Python | 3.12.5(sentence-transformers 5.6.0 / faster-whisper 1.2.1 / MCP Python SDK) |
| 生成の設定 | temperature 0.2・同じ指示を3回ずつ |
用語集
| 用語 | 平たく言うと | なぜ効くのか |
|---|---|---|
| ローカルLLM | 手元のパソコンの中だけで動く言語モデル | ネットに出ないので無料。止まらないし、入力が外へ出ない |
| エージェント | 答えるだけでなく、道具を使って何かをするAI | この記事の主題。「会話」との違いは道具を持つかどうか |
| GGUF | llama.cpp が読むモデルのファイル形式 | 1ファイルで完結する。これを置けば動く |
| 量子化 | モデルの数値を粗くしてファイルを小さくすること | Q4_K_M は約4ビット。14Bが8GB台に収まる(削られ方はp965で実測) |
| 道具(ツール) | AIから呼べる関数。時計を見る、ファイルを読む、など | ★今回の山。呼び方の作法がモデルごとに違う |
| tool calling | 「この道具をこの引数で呼びたい」をAIに構造化して返させるしくみ | サーバ側が解釈してくれる。ただしモデルが作法を守れば |
| チャットテンプレート | 会話や道具一覧を、そのモデルが習った形の文字列に組み立てる型紙 | GGUFの中に入っている。道具の書き方もここに書かれている |
| RAG | 手元の文章を検索して、見つけた部分だけをAIに読ませるやり方 | モデルを作り直さずに「自分のこと」を覚えさせられる |
| MCP | AIに道具を差し出すための共通の約束ごと | 自分で書かなくても、人の作った道具を繋げる(p992) |
| tok/s | 1秒あたりに読む/書ける単語のかけら(トークン)の数 | 体感の速さ。読む速さと書く速さは別物(p964) |
【全体像】エージェントは4つの部品でできている
「AIエージェント」と言うと難しそうですが、中身は4つしかありません。頭(モデル)、会話を続けるループ、手足になる道具、覚えておく場所です。MCPは4つ目の外側、「よその道具を借りる口」にあたります。
この記事は、この図を左上から順に1つずつ足していく形で進みます。段1だけでも動きますし、段3で止めても十分に使えます。
【必要なもの】どのモデルなら手元で動くのか
最初の関門はモデルがメモリに載るかです。ここを外すと、何を作っても遅くて使い物になりません。4つのモデルを同じ条件で測りました。
llama-bench -m モデル.gguf -p 512 -n 128 -r 3
| モデル(Q4_K_M) | ファイル | 実メモリ | 起動 | 読む速さ | 書く速さ |
|---|---|---|---|---|---|
| Qwen2.5 3B | 1.79 GiB | 2.15 GB | 2.1秒 | 528.2 tok/s | 41.7 tok/s |
| Qwen2.5-Coder 7B | 4.36 GiB | 4.68 GB | 4.1秒 | 226.2 tok/s | 20.4 tok/s |
| Qwen2.5-Coder 14B | 8.37 GiB | 9.47 GB | 7.2秒 | 107.9 tok/s | 10.6 tok/s |
| Ministral 3 14B | 7.67 GiB | 8.59 GB | 6.1秒 | 125.6 tok/s | 12.4 tok/s |
きれいに2倍のモデルは2倍遅いという並びです。3Bから14Bで、書く速さは41.7→10.6と約4分の1になりました。
必要なメモリの目安
実メモリはファイルサイズ+0.3〜1.1GBでした。会話の履歴を置く場所(コンテキスト)のぶんです。Macの統合メモリなら本体のメモリがそのまま使えますが、グラフィックボードのVRAMは固定なので、そこに収まるかで決まります。12GBのRTX 3060では14B(約9.5GB)が入り、8GBなら7Bまで。溢れた瞬間に10倍以上遅くなります(p963で実測しました)。
ここまでだと「メモリが許すなら大きいほうが良い」と読めます。実際、eightもそう思って段3に進みました。
【下ごしらえ】道具を入れる ── 全部で3つだけ
段1に入る前に、手元に置くものを揃えます。入れるのは「モデルを動かすもの」「Python」「モデルそのもの」の3つだけです。専用のフレームワークは出てきません。
1. モデルを動かすもの(llama.cpp)
Macなら Homebrew で1行です。C++で書かれていて、Python は要りません。
brew install llama.cpp
llama-server --version     # 例: version: 10090 (7347430f4)
これで llama-server(サーバとして動かす)・llama-cli(端末で対話する)・llama-bench(速さを測る)が入ります。この記事の速度はすべて llama-bench の数字です。
Ollama でもよいのか
よいです。入れやすさなら Ollama(brew install ollama → ollama run qwen2.5:3b だけで対話まで届きます)。この記事で llama.cpp を主役にしたのは、モデルの置き場所と設定が目に見えるからです。実際、段3で「道具の書き方はモデルの中のどこに入っているのか」を追いかけるとき、この違いが効きました。なお Ollama で入れたモデルの実体もGGUFなので、llama.cpp からそのまま読めます(この記事の3Bはそうしています)。
2. Python と、段ごとに要るもの
使ったのは Python 3.12.5(pyenv 2.5.1 で入れたもの)です。段によって必要なものが違うので、進んだところまで入れれば足ります。
| 段 | 入れるもの | 使ったバージョン | ディスク |
|---|---|---|---|
| 段1〜3(会話・道具) | pip install requests | 2.33.1 | 約1MB |
| 段4(記憶) | pip install sentence-transformers numpy | 5.6.0 / 1.26.4 | ⚠約540MB |
| 段5(MCP) | pip install mcp | 1.27.0 | 約4MB |
| 段6(画面) | pip install PySide6 | 6.11.1 | ⚠約1.1GB |
⚠段1〜3は requests だけです。重いのは後半で、sentence-transformers が PyTorch(531MB)を連れてくるのと、PySide6 が1.1GBあることです。「AIを動かすと重い」のではなく、記憶と画面が重いという内訳になります。
⚠pip install mcp は現在 2.x が入り、クラス名が変わっています。1.x系の書き方で進めるなら pip install "mcp<2" です(p992で踏みました)。
3. モデルそのもの(GGUF)
モデルは1ファイルです。Hugging Face から取ってきて、好きな場所に置くだけで動きます。
pip install huggingface-hub

# 3B(いちばん軽い・約1.9GB)
hf download Qwen/Qwen2.5-3B-Instruct-GGUF \
  --include "qwen2.5-3b-instruct-q4_k_m.gguf" --local-dir ./models

# Ministral 3 14B(この記事で道具がいちばん素直だったもの・約8GB)
hf download mistralai/Ministral-3-14B-Instruct-2512-GGUF \
  --include "Ministral-3-14B-Instruct-2512-Q4_K_M.gguf" --local-dir ./models
⚠ファイル名の指定を省かないでください。 リポジトリには量子化の種類ごとに何十個ものGGUFが入っていて、指定しないと全部落ちてきます。⚠もうひとつ、大きいモデルは分割して置かれていることがあります。たとえば Qwen2.5-Coder 7B には ...q4_k_m.gguf と ...q4_k_m-00001-of-00002.gguf の両方があり、分割版を1つだけ取ると動きません。
置いたら、段1のコマンドで起動できます。★モデルのファイル名にバージョン管理の仕組みはありません。どれを使ったか分からなくなるので、置き場所は1つに決めておくと後が楽です。
【段1】文字で1往復させる ── 10行
まずモデルを置いて、サーバとして起動します。これだけで、もうAIは手元で動いています。
llama-server -m Qwen2.5-Coder-7B-Instruct-Q4_K_M.gguf \
  --port 8080 --ctx-size 8192 -ngl 99
-ngl 99 は「全部GPUに載せる」の意味です。あとはHTTPで投げるだけで、中身はよくある形式なので特別なライブラリも要りません。
import requests

URL = "http://127.0.0.1:8080/v1/chat/completions"

def ask(text):
    r = requests.post(URL, json={
        "messages": [{"role": "user", "content": text}],
        "temperature": 0.2,
    }, timeout=120)
    return r.json()["choices"][0]["message"]["content"]

print(ask("自己紹介を1文でしてください。"))
返ってきた答えはこうでした。
私はQwen、アリババクラウドが作成した大規模な言語モデルです。
コメントを除いて10行です。ここが土台になります。
【段2】会話を続ける ── 20行
段1は毎回まっさらなので、「さっきの話」が通じません。前の発言を配列に積んで一緒に送るだけで、話し相手になります。
KEEP = 8   # 直近8メッセージ(4往復)だけ持つ
SYSTEM = "あなたは日本語で簡潔に答えるアシスタントです。"

def chat(history, text):
    history.append({"role": "user", "content": text})
    msgs = [{"role": "system", "content": SYSTEM}] + history[-KEEP:]
    r = requests.post(URL, json={"messages": msgs, "temperature": 0.2}, timeout=120)
    answer = r.json()["choices"][0]["message"]["content"]
    history.append({"role": "assistant", "content": answer})
    return answer
★履歴を無限に伸ばさないのがコツです。入力が長くなるほど1文字目までの待ち時間が伸びます(p964では入力8,192トークンで39秒かかりました)。ただし切り詰めるとそのぶん読み直しが発生するので、p966ではこれが原因で待ち時間が2.2倍になりました。「どこで切るか」は、速さと記憶のつりあいです。
【段3】道具を持たせる ── ここからがエージェント
ここが分かれ目です。道具を持った瞬間に、AIは「答える人」から「やる人」になります。
渡す道具は3つにしました。前回Blenderを操作させた回で、「何でもできる1つ」より「意味のある3つ」のほうが桁違いに当たる(13% → 100%)と分かっているためです。
def now(timezone: str = "Asia/Tokyo") -> str:
    """いまの日時を返す。"""
    return datetime.datetime.now(zoneinfo.ZoneInfo(timezone)).strftime("%Y-%m-%d %H:%M:%S")

def list_files(directory: str = ".") -> str:
    """フォルダの中身を一覧にする。"""
    ...

def save_note(title: str, body: str) -> str:
    """メモを1件保存する。"""
    ...
渡し方には2通りあります。
Aのほうが行数も少なく、素直です。--jinja を付けてサーバを起動すれば、道具の一覧をそのまま渡せます。
r = requests.post(URL, json={"messages": msgs, "tools": SCHEMA, "temperature": 0.2})
m = r.json()["choices"][0]["message"]
for c in m.get("tool_calls") or []:
    name = c["function"]["name"]
    args = json.loads(c["function"]["arguments"])
    msgs.append({"role": "tool", "tool_call_id": c["id"],
                 "name": name, "content": call(name, args)})
ところが、7Bで動かしたら道具がひとつも動きませんでした。
【続き・実測】同じ道具を4つのモデルに渡す
1回で決めつけないよう、10個の指示を3回ずつ与えました。10個のうち8個は道具が要る指示、2個は要らない指示です(「日本の首都は?」に道具を呼びに行かないかも見たいため)。合計30回×2通り×4モデルです。
| モデル | A:サーバの道具機能 | B:自分でJSONを拾う | 要らないのに呼んだ |
|---|---|---|---|
| Qwen2.5 3B | 24/24 | 24/24 | 0/6 |
| Qwen2.5-Coder 7B | 0/24 | 24/24 | 0/6 |
| Qwen2.5-Coder 14B | 0/24 | 24/24 | 0/6 |
| Ministral 3 14B | 24/24 | 24/24 | 0/6 |
いちばん小さい3Bが満点で、Coderの7Bと14Bは1回も呼べなかった
しかも7Bと14Bは同じ0点です。大きさの問題ではありません。そして自分でJSONを拾う方式なら、4モデルすべてが96回中96回当てています。
要らない指示で道具を呼びに行った例は、4モデルとも0件でした。「呼びすぎる」ほうの心配はしなくてよさそうです。
【続き・切り分け】テンプレートを入れ替えても直らなかった
最初に疑ったのは、こちらの設定ミスです。道具の書き方はGGUFの中のチャットテンプレートに入っているので、まずそれを取り出して見比べました。
curl -s http://127.0.0.1:8080/props | python3 -c \
  "import json,sys; print(json.load(sys.stdin)['chat_template'])"
3Bと7Bのテンプレートは、2,500文字あるうち2文字しか違いませんでした。
3B :  <tool_call>{{"name": <function-name>, "arguments": <args-json-object>}}</tool_call>
7B :  <tool_call>{"name": <function-name>, "arguments": <args-json-object>}</tool_call>
波括弧が二重か一重かの違いだけです(しかも正しいのは7Bのほうで、3Bは例が壊れています)。それでも念のため、7Bに3Bのテンプレートを渡して同じ30回を回しました。
| 条件 | A:サーバの道具機能 |
|---|---|
| 7B・自分のテンプレート | 0/24 |
| 7B・3Bのテンプレートを渡す | 0/24(変わらず) |
次に「サーバが強制していないだけでは」と考えて、tool_choice に required(道具を必ず使え)を指定してみました。これも変わりません。設定の問題ではありませんでした。
【続き】生の文字を見に行く ── 包み方だけが違っていた
ここで、モデルが書いた生の文字を見ることにしました。/v1/chat/completions はサーバが解釈したあとの姿しか返さないので、/apply-template で組み立てたプロンプトを /completion にそのまま投げます。
p = requests.post(f"{BASE}/apply-template",
                  json={"messages": msgs, "tools": SCHEMA}).json()
r = requests.post(f"{BASE}/completion",
                  json={"prompt": p["prompt"], "temperature": 0.2, "n_predict": 128}).json()
print(repr(r["content"]))
同じ「いま何時ですか?」に対して、2つのモデルはこう書いていました。
Qwen2.5-Coder 7B:
'```json\n{"name": "now", "arguments": {"timezone": "Asia/Tokyo"}}\n```'

Qwen2.5 3B:
'<tool_call>\n{"name": "now", "arguments": {"timezone": "Asia/Tokyo"}}\n</tool_call>'
中身は完全に正解している
道具の名前も、引数も、タイムゾーンまで合っています。違うのは包み方だけです。テンプレートは「<tool_call> で囲め」と書いているのに、Coderはマークダウンのコードブロックで囲みました。囲みが違えばサーバは見つけられず、ただの文章として素通りします。
しかも囲み方は毎回違いました。14Bは <tools>(複数形)で囲み、7Bは別の試行で ```xml と書いて中身をXMLに組み替えたこともあります。コードを書くのが得意なモデルほど、コードブロックで囲みたがる——原因はそういう「癖」でした。
★これはp993で踏んだ教訓と同じ形です。外から見えるのは「動いたかどうか」だけで、なぜそうなったかは中を見ないと分かりません。 表の0/24を眺めているうちは、ずっとサーバの設定を疑っていました。
【続き・実際の出力】同じ指示に、4モデルは何と答えたか
ここまでは「道具が動いたか」という数字だけを見てきました。⚠数字が良いことと、使って気持ちよく動くことは別です。同じ指示に対して実際に返ってきた文面を、手を加えずに並べます。
入力:いま何時ですか?(道具は 17:12〜17:23 を返しています)
Qwen2.5 3B      A: 現在の時刻は2026年9月12日 17時22分42秒です。
                B: 現在の時刻は日本時間で8時23分15秒です。        ← ⚠8時?

Qwen2.5-Coder 7B  A: ```json
                     {"name": "now", "arguments": {"timezone": "Asia/Tokyo"}}
                     ```                                          ← ⚠これが答えとして出る
                  B: 現在時刻は2026年9月12日17時12分45秒です。

Qwen2.5-Coder 14B A: <tools>
                     {"name": "now", "arguments": {"timezone": "Asia/Tokyo"}}
                     </tools>
                  B: 2026年9月12日17時15分59秒です。

Ministral 3 14B   A: 現在の時間は、17時18分です。
                  B: 現在の時間は、17時20分です。
★★3Bは道具を呼べていたのに、答えを間違えた
道具は 17:23:15 を返しているのに、「8時23分15秒です」と答えています。3回のうち2回がこれでした。分と秒は合っているので、時だけ読み違えています。前回と同じ形——道具が当たったことと、答えが合っていることは別です。
入力:「買い物」という題で「牛乳とパン」というメモを保存してください
Qwen2.5 3B      A: メモが保存されました:買い物.txt
Qwen2.5-Coder 7B  A: ```json
                     {"name": "save_note", "arguments": {"title": "買い物", "body": "牛乳とパン"}}
                     ```
                  B: メモが保存されました。
Ministral 3 14B   A: 「買い物」のメモを保存しました。
Bの方式では4モデルともファイルが正しくできていました。中身も指示どおりです。
$ cat lab/notes/買い物.txt
牛乳とパン
$ cat lab/notes/memo.txt
資料を作る
入力:日本の首都はどこですか?(道具は要らない)
Qwen2.5 3B      A: {{"name": "now", "arguments": {"timezone": "Asia/Tokyo"}}}   ← ⚠要らないのに
                B: 日本の首都は東京です。
Qwen2.5-Coder 7B  A: {"name": "now", "arguments": {"timezone": "Asia/Tokyo"}}
                  B: 日本の首都は東京です。
Ministral 3 14B   A: 日本の首都は東京です。
                  B: 東京です。
★ここは先ほどの表の見方を直さないといけません。表では「要らないのに呼んだ 0/6」と書きましたが、3Bと7Bは呼ぼうとしています。囲み方が違うせいで道具として認識されず、結果としてJSONがそのまま利用者の目に入るだけでした。「呼ばなかった」のではなく「呼び損ねた」のです。
★答えに道具の呼び出しが漏れた回数
そこで、30回それぞれの最終的な答えに、JSONやタグが混ざっていないかを数え直しました。
| モデル | A:サーバの道具機能 | B:自分でJSONを拾う |
|---|---|---|
| Qwen2.5 3B | 3/30 | 0/30 |
| Qwen2.5-Coder 7B | 27/30 | 0/30 |
| Qwen2.5-Coder 14B | 24/30 | 0/30 |
| Ministral 3 14B | 0/30 | 0/30 |
★文面まで見ると、4モデルのうち最後まできれいだったのは Ministral 3 だけでした。3Bは道具の呼び出しでは満点でしたが、時刻を読み違え、要らない場面でJSONを漏らしています。⚠成功率の表だけを見ていたら、3Bを勧めるところでした。
【段4】記憶を持たせる ── 自分の文章を意味で引く
道具の次は記憶です。ここではブログ全記事を読ませた回と同じやり方を、いちばん短い形で書きます。文章を数値の並びに変えておいて、質問も数値に変えて、近いものを探します。
使う埋め込みモデルは多言語対応の e5-small(470MB)。これもローカルで動きます。素材はこのブログの記事102本です。
# ★e5系は接頭辞が要る(passage: / query:)。付け忘れると精度が落ちる
vecs = m.encode([f"passage: {t}" for t in texts], normalize_embeddings=True)
...
q = m.encode([f"query: {question}"], normalize_embeddings=True)[0]
score = vecs @ q                      # 全部との近さを一度に出す
top = np.argsort(-score)[:3]
| 測ったもの | 結果 |
|---|---|
| 記事102本の索引づくり | 4.4秒(43ms/件) |
| できた索引のサイズ | 0.2MB(384次元) |
| 質問を数値にする | 27ms |
| 102本と照合する | 0.40ms |
| ⚠埋め込みモデルの読み込み | 9〜10秒 |
「ローカルLLMを動かすには何GB必要か」と聞いた結果です。
0.889  p954  数GB級のLLMをNeural Engineで動かしてみた〜「806MBの崖」の正体を追いかけた〜
0.888  p951  ローカルLLM推論エンジン対決〜Metal・MLX・CUDAで同じモデルを走らせて測る〜
0.882  p941  ローカルLLMでオフラインのコーディング相棒を作ってみた〜ネットなしで動く開発アシスタント〜
★検索そのものは一瞬です(0.40ms)。時間を食っているのはモデルの読み込み9秒のほうで、しかも1回きりの費用です。つまり常駐させれば体感はゼロになります。都度起動する作りにすると、ここで9秒待たされ続けることになります。
【段5】MCPで外の道具を足す
最後に、自分で書いていない道具を足します。前々回作ったブログ検索のMCPサーバーをそのまま繋ぎます。やることは道具の一覧に混ぜるだけです。
listed = (await s.list_tools()).tools
schema = list(tools.SCHEMA) + [
    {"type": "function", "function": {
        "name": "mcp__blog__" + t.name,          # ★名前空間を付ける
        "description": t.description or "",
        "parameters": t.inputSchema}} for t in listed]
⚠mcp__サーバ名__道具名 にしているのは、p949で内蔵の read_file とMCP側の read_file がぶつかり、黙って別のほうが動いたためです。作る側でも呼ぶ側でも、名前は具体的にしておきます。
動かすと、内蔵の3つと外の2つが同じ一覧に並びます。
使える道具: ['now', 'list_files', 'save_note',
            'mcp__blog__search_blog_posts', 'mcp__blog__get_blog_stats']

> ブログでMCPを扱った記事を教えてください。
  -> mcp__blog__search_blog_posts({'query': 'MCP', 'limit': 5})

1. AIにBlenderを操作させる〜MCPで3Dソフトを道具として渡す〜(2026.09.12)
2. MCPサーバーを自分で作る〜AIから自分の道具を叩けるようにする〜(2026.09.05)
3. Appleが配り始めたAI移植スキルを使ってみた(2026.08.01)
4. ローカルAIエージェントにMCPで外部ツールを繋いでみた(2026.07.13)
5. ローカルLLMでAIエージェントを作ってみた(2026.07.02)
前日に公開したばかりの記事まで拾えています。ここまでで50行、そして一度もネットに出ていません。
⚠段5は道具機能を使うので、ここで使えるモデルは段3の表で満点だったものに限られます。Coderを繋ぐと、道具の一覧は見えているのに1回も呼ばれません。
【段6】画面を付ける ── ここまで端末の中だけだった
段5まではすべて端末の中の話でした。最後に窓を1枚かぶせます。中身は段3の道具ループをそのまま呼ぶだけで、AIの処理は1行も変わりません。
class Worker(QObject):
    done = Signal(str, list)

    def run(self):
        answer, used = agent.run(self.text)     # ★段3をそのまま呼ぶ
        self.done.emit(answer, used)

def ask(self):
    ...
    self.thread = QThread()                     # ★別スレッドへ逃がす
    self.worker = Worker(text)
    self.worker.moveToThread(self.thread)
    self.thread.started.connect(self.worker.run)
    self.worker.done.connect(self.show_answer)
    self.thread.start()
★生成は必ず別スレッドで回します。同じスレッドで待つと窓が固まり、利用者には「遅い」ではなく「壊れた」ように見えます。p966で、同期呼び出しにすると描画フレームが1枚も出なくなったのと同じ話です。
Ministral 3 を繋いで、2つ続けて話しかけた画面です。
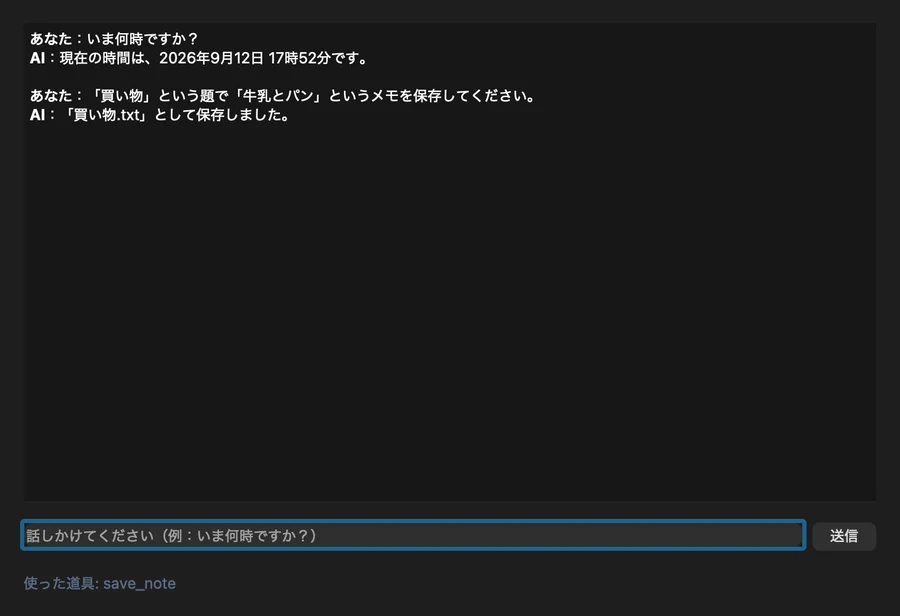
⚠下に「使った道具」を出しているのは、見た目の飾りではありません。段3で見たとおり、道具を呼べていないのに答えだけそれらしく返ってくることがあります。何を使って答えたのかが見えないと、間違いに気づけません。
ここまでで81行です。この窓に音声(p936・p937)や画像の理解、モデルの切り替え(p941)を足していくと、最初に作ったエージェントの姿になります。
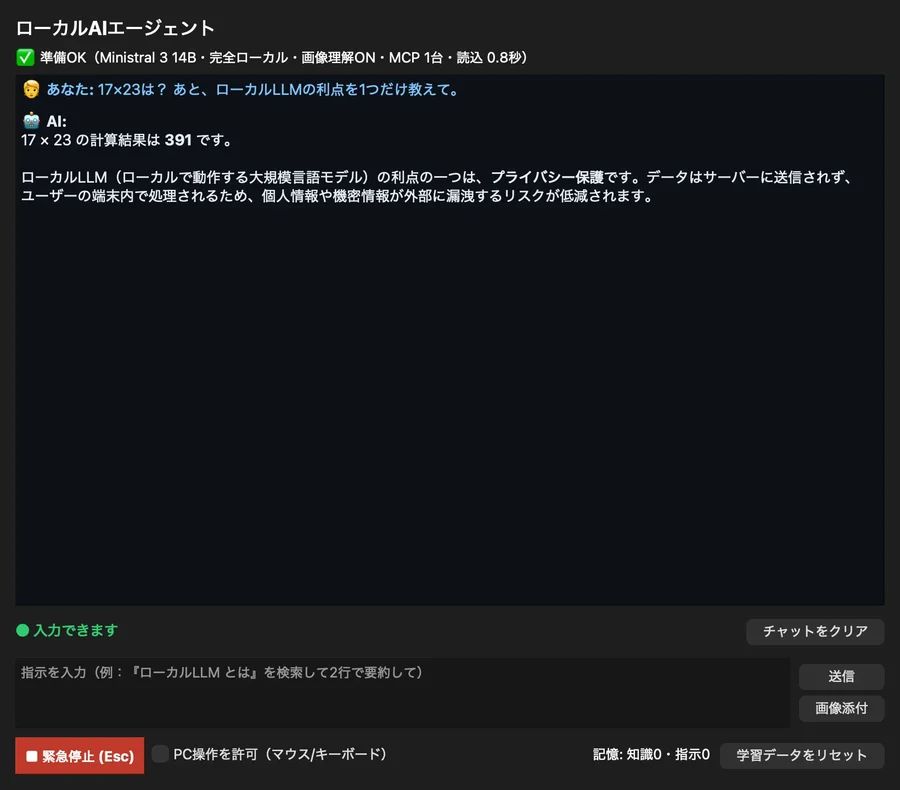
積み上がると、モデルの表示、緊急停止、PC操作の許可、記憶のリセットといったものが増えていきます。★どれも「AIを賢くする」機能ではなく、「いま何が起きているかを見せる」「止められるようにする」ための部品です。手元で動かすほど、この2つが効いてきます。
【整理】どこから作るか・どれを選ぶか
モデル選びは、大きさより先に見るところがあります。
| やりたいこと | 選び方 | 理由 |
|---|---|---|
| とりあえず動かしたい | 3Bから | 2.15GBで41.7 tok/s。ほとんどのパソコンで動く。⚠ただし答えの取り違えがある |
| 道具を使わせたい | ★先に3回試して、答えの文面まで読む | 大きさでは分からない。0点のモデルがある |
| そのまま使えるものがほしい | Ministral 3 14B | ★今回文面まできれいだったのはこれだけ(漏れ0/60) |
| 文章の質がほしい | 14B級(メモリ10GB以上) | ただし書く速さは10 tok/s台まで落ちる |
| コードを書かせたい | Coder系 | ⚠ただし道具は自分でJSONを拾う方式で |
| どのモデルでも動く作りにしたい | B方式(自分で拾う) | 17行多いだけで、4モデルすべて満点だった |
【無料でどこまでできるのか】
ここまでで払った金額は0円です。使ったものを並べます。
| 部品 | 使ったもの | 大きさ | 費用 |
|---|---|---|---|
| 推論 | llama.cpp(Homebrewで導入)/ Ollama | 数十MB | 0円 |
| モデル | Qwen2.5 / Qwen2.5-Coder / Ministral 3 | 1.8〜8.4GB | 0円 |
| 記憶 | multilingual-e5-small | 470MB | 0円 |
| 音声入力 | faster-whisper(p936・p950) | 約500MB(small) | 0円 |
| 音声出力 | VOICEVOX ENGINE(p937) | 約1GB | 0円 |
| 外部の道具 | MCP Python SDK | 数MB | 0円 |
⚠「無料で使える」と「何に使ってよいか」は別
ライセンスはモデルごとに違います。今回の4つでも、Qwen2.5-Coder 7B と Ministral 3 14B は Apache 2.0 ですが、Qwen2.5 3B は qwen-research(研究用)でした。いちばん手軽で成績も良かった3Bが、いちばん条件が厳しいという並びです。仕事で使うなら、配布元のライセンス表記を必ず読んでください。
かかるのはディスクと時間だけです。全部入れても10GB前後で、いまどきのパソコンなら収まります。
つまずき集
| 症状 | 原因と対処 |
|---|---|
| ★★道具の一覧を渡したのに1回も呼ばれない | モデルが決められた印で囲んでいない。生の出力を見る(/apply-template+/completion)。直らなければ自分でJSONを拾う方式に変える |
| ★★答えの代わりにJSONがそのまま画面に出る | 道具として認識されず、文章として素通りしている。Coder 7Bでは30回中27回これが起きた。⚠利用者から見ると「壊れている」ので、道具が漏れていないかを必ず目視する |
| ★窓が固まって操作できない | 生成をUIと同じスレッドで待っている。別スレッドへ逃がす(Qtなら QThread + moveToThread) |
★Macなのに C:\Users\… を前提に答える | 「デスクトップを一覧にして」と頼んだら、Windowsのパスを想像して失敗した。道具の引数に曖昧な場所を渡さない(呼ぶ側で実際のパスに直す) |
| MCPの道具を繋いだら、内蔵の道具が動かなくなった | 同じ名前でぶつかっている。mcp__サーバ名__道具名 で名前空間を付ける(p949) |
| MCPの道具が失敗しているのに成功扱いになる | ⚠失敗は error ではなく isError で返る(p992で自作クライアントのバグとして見つけました) |
| 会話が長くなると急に待たされる | 履歴を切り詰めた瞬間に読み直しが起きている。p966で待ち時間が2.2倍になりました |
| 検索が毎回9秒かかる | 埋め込みモデルの読み込み。常駐させる。照合そのものは0.40ms |
| 意味で引いたのに的外れなものが出る | e5系は passage: / query: の接頭辞が要る。付け忘れが定番 |
| 14Bを載せたら急に遅い | VRAMから溢れている。p963のとおり、溢れると桁で落ちる。★Macで --n-cpu-moe や -ot を使うときは --no-mmap も付ける |
Windowsで python3 が動かない | 0バイトのストア用エイリアスに化けていることがある(p949) |
まとめ
- エージェントの中身は4つの部品(モデル・会話ループ・道具・記憶)。MCPはその外側に足す口
- ★話すだけなら10行、道具を持たせても31〜48行。画面まで付けて81行で、専用のフレームワークは要らない
- ★モデルの実メモリはファイルサイズ+0.3〜1.1GB。3Bなら2.15GB・41.7 tok/s で、たいていのパソコンに載る
- 速さはきれいに大きさどおり。3Bから14Bで書く速さが約4分の1(41.7→10.6 tok/s)
- ★★同じ道具を4つのモデルに渡したら、Coderの7Bと14Bは24回中0回しか呼べなかった。いちばん小さい3Bは24/24
- ★★⚠ただし「呼べた」と「正しく答えた」は別だった。3Bは道具が返した
17:23:15を「8時23分15秒です」と答えている(3回中2回)。★文面まで見ると、最後まできれいだったのは Ministral 3 だけ(答えに道具の呼び出しが漏れた回数 0/60。Coder 7Bは27/30) - ★★原因は賢さでも設定でもなく包み方だった。中身(道具名・引数・タイムゾーン)は完全に正解していて、
<tool_call>の代わりにマークダウンのコードブロックで囲んでいただけ - ★切り分けとしてテンプレートを入れ替えても、
tool_choiceを必須にしても0/24のままだった。⚠表を眺めている間は、ずっとこちらの設定を疑っていた - ★自分でJSONを拾う方式なら4モデルすべて96/96。17行多いだけで、モデルを選ばない保険になる
- 記憶は思ったより軽い。102本の索引が0.2MB・4.4秒、照合は0.40ms。⚠重いのは埋め込みモデルの読み込み9秒のほうで、常駐させれば消える
- ⚠「要らないのに呼んだ 0/6」は読み違いだった。3Bと7Bは呼ぼうとして呼び損ねていただけで、そのJSONがそのまま利用者に見えていた。★数字の列だけ見ていると、失敗を成功と数えてしまう
- ⚠「無料で動く」と「自由に使ってよい」は別。同じ手軽さでも Apache 2.0 と研究用ライセンスが混ざっている
作る前は「大きいモデルほど何でもできる」と思っていました。実際に測ると、大きさでは決まらず、コードが得意なCoderほど自己流の書き方で返してきました。そして数字の表だけを見ていたら、時刻を読み違える3Bを勧めていました。エージェントを組むときに確かめるべきは、賢さでも成功率でもなく、返ってきた文面をそのまま読むことでした😳
それでは、今回はここまで。最後までありがとうございました😊
参考サイト
- llama.cpp(今回の推論エンジン。
llama-server/llama-bench/--jinjaはここのドキュメント) - Ollama(3Bモデルの入手に使用。GGUFは共有ディレクトリに置かれます)
- Qwen2.5-Coder-7B-Instruct(Apache 2.0)
- Qwen2.5-3B-Instruct(⚠ qwen-research ライセンス)
- Ministral-3-14B-Instruct-2512(Apache 2.0)
- multilingual-e5-small(記憶に使った埋め込みモデル。
passage:/query:の接頭辞の説明もここ) - Model Context Protocol(MCPの仕様)
- MCP Python SDK(段5で使用)
- VOICEVOX(音声出力。使用条件は配布元を参照)